2026 年 9 月 1 日,全球权威 AI 性能评测组织 MLCommons 正式发布 MLPerf Storage v3.0 基准测试榜单。焱融全闪 AI 存储 F9000X 凭借优异的软硬件架构和数据传输能力,性能再创世界纪录。在 3D U-Net 模型训练测试中,三节点存储集群聚合带宽达到 544GiB/s,近乎将高速网络带宽全部打满;在 Checkpoint 70B 测试中,集群读、写带宽同样双双位列第一,全面领跑全球 AI 存储赛道。

MLPerf 是目前全球极具权威性和影响力的 AI 性能基准测试体系,其测试结果被业内公认为衡量 AI 硬件综合实力的“黄金标准”。本次 MLPerf Storage v3.0 新增 KVCache 测试用例,进一步扩展了其对 AI 全场景工作负载的覆盖能力。
本次测试中,硬件集群环境由 3 台焱融 F9000X 全闪存储节点和 9 台 x86 客户端服务器组成,依托 NVIDIA QM9700 交换机实现 NDR400 高速网络互联。每个 F9000X 存储节点采用 2U 通用 x86 服务器平台,搭载英特尔至强® 6900P(Granite Rapids,GNR-AP)处理器、PCIe Gen5 NVMe SSD 闪存及 4 块 NVIDIA ConnectX-7 400Gbps InfiniBand 网卡,构建高带宽、低时延的全闪存储测试环境。
Granite Rapids处理器作为英特尔新一代数据中心平台,不仅提供更强的核心性能和 I/O 吞吐能力,还支持 MRDIMM(Multiplexed Rank DIMM)高性能内存技术,将单条内存速率提升至 8800MT/s,在元数据管理、并发 I/O 调度、Checkpoint 处理以及 KV Cache 等 AI 存储关键场景中显著降低内存访问瓶颈。GNR-AP 与 MRDIMM 的结合,为焱融 YRCloudFile 并行文件系统提供了更强的数据处理能力和更高的存储访问效率,进一步释放 PCIe Gen5 SSD 与 400G 网络的性能潜力。

焱融存储 MLPerf Storage v3.0 测试环境架构
训练场景极致吞:544GiB/s 满带宽输出,斩获全球第一
作为 AI 训练场景中对存储带宽、数据吞吐能力诉求最严苛的测试项,3D U-Net 模型训练极度考验存储系统的持续带宽输出能力和极限负载稳定性。本次 v3.0 测试中,焱融 F9000X 三节点全闪存储集群聚合带宽 544GiB/s,近乎将高速网络带宽全部“打满”,斩获该场景性能第一。
这充分验证了焱融全闪 F9000X 在极限 AI 训练负载下对高速网络带宽的高效利用能力,能够以更少的存储节点释放更强的数据供给能力,满足大规模 AI 训练对高带宽存储的需求。同时,极致的带宽利用率,不仅意味着更高的 GPU 数据供给效率,更意味着企业能以更少的存储节点支撑更大的 AI 算力规模,从而降低整体存储成本。
这一成绩的背后,是焱融对 AI 存储软硬件协同优化的持续投入。从 MLPerf Storage 历届测试结果来看,在 3D U-Net 场景中,焱融持续刷新 AI 存储性能纪录:从 v2.0 的 478GiB/s,到本届 v3.0 的 544GiB/s,不仅创下焱融自身历史最高成绩,同时在通用硬件环境下,也达到了历届公开测试成绩中的最高水平。
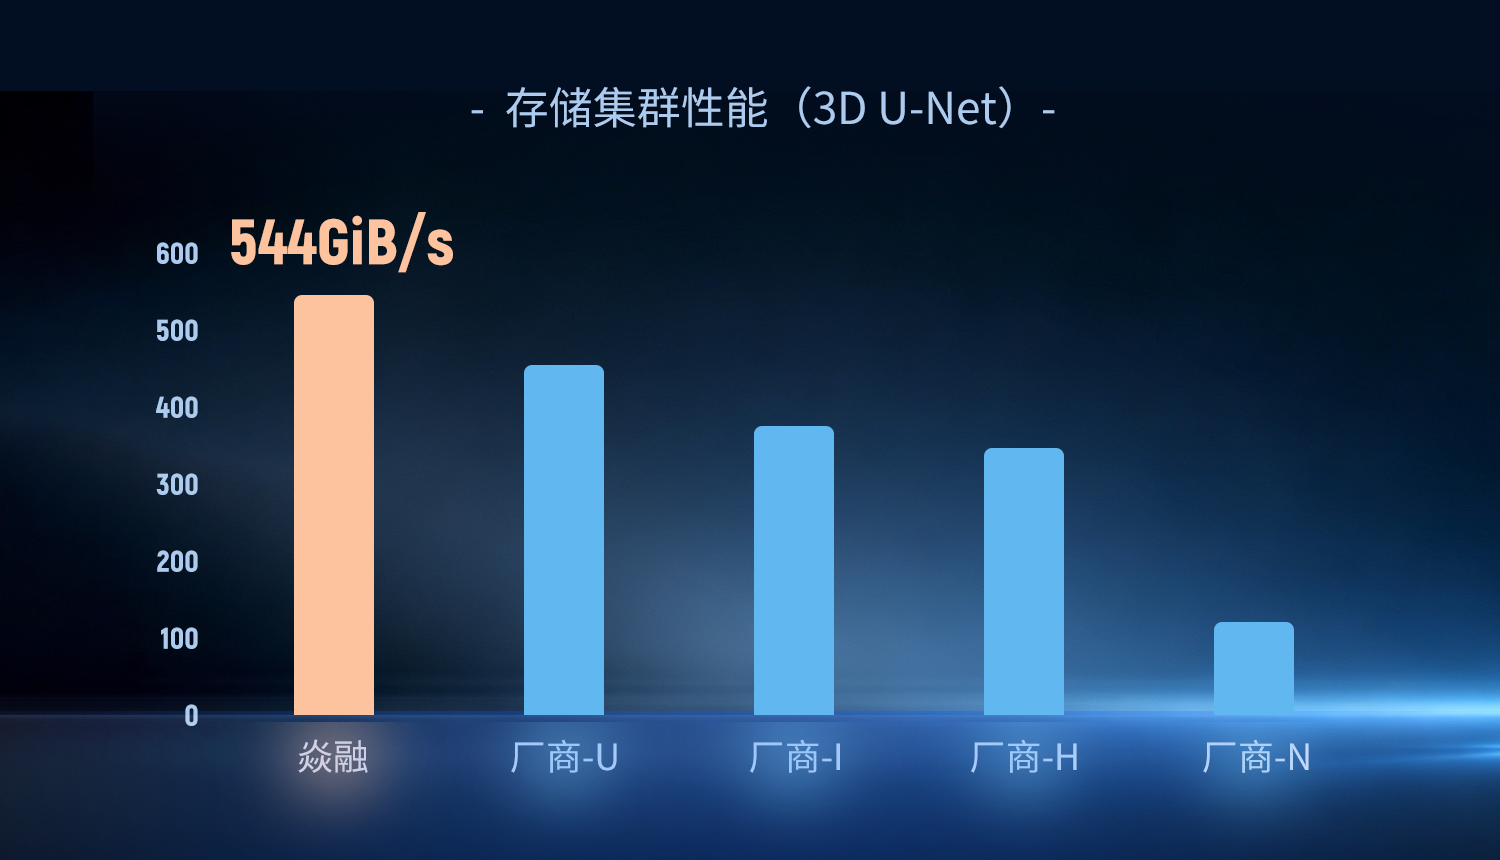
3D U-Net测试:训练存储集群聚合带宽性能位列第一
高效断点续:Checkpoint 70B场景读写双冠
在 Checkpoint 70B 测试中,焱融存储集群实现 539GiB/s 的读带宽和 314GiB/s 的写带宽,读写性能均位居全球第一,双双刷新历届 MLPerf Storage 公开测试成绩最高水平。优异的断点读写性能,可极大缩短千亿级万亿级大模型训练的存档与恢复耗时,有效规避训练中断导致的算力浪费与时间损耗,显著提升大规模大模型训练的连续性与稳定性,全方位保障 AI 大模型高效训推的核心需求。
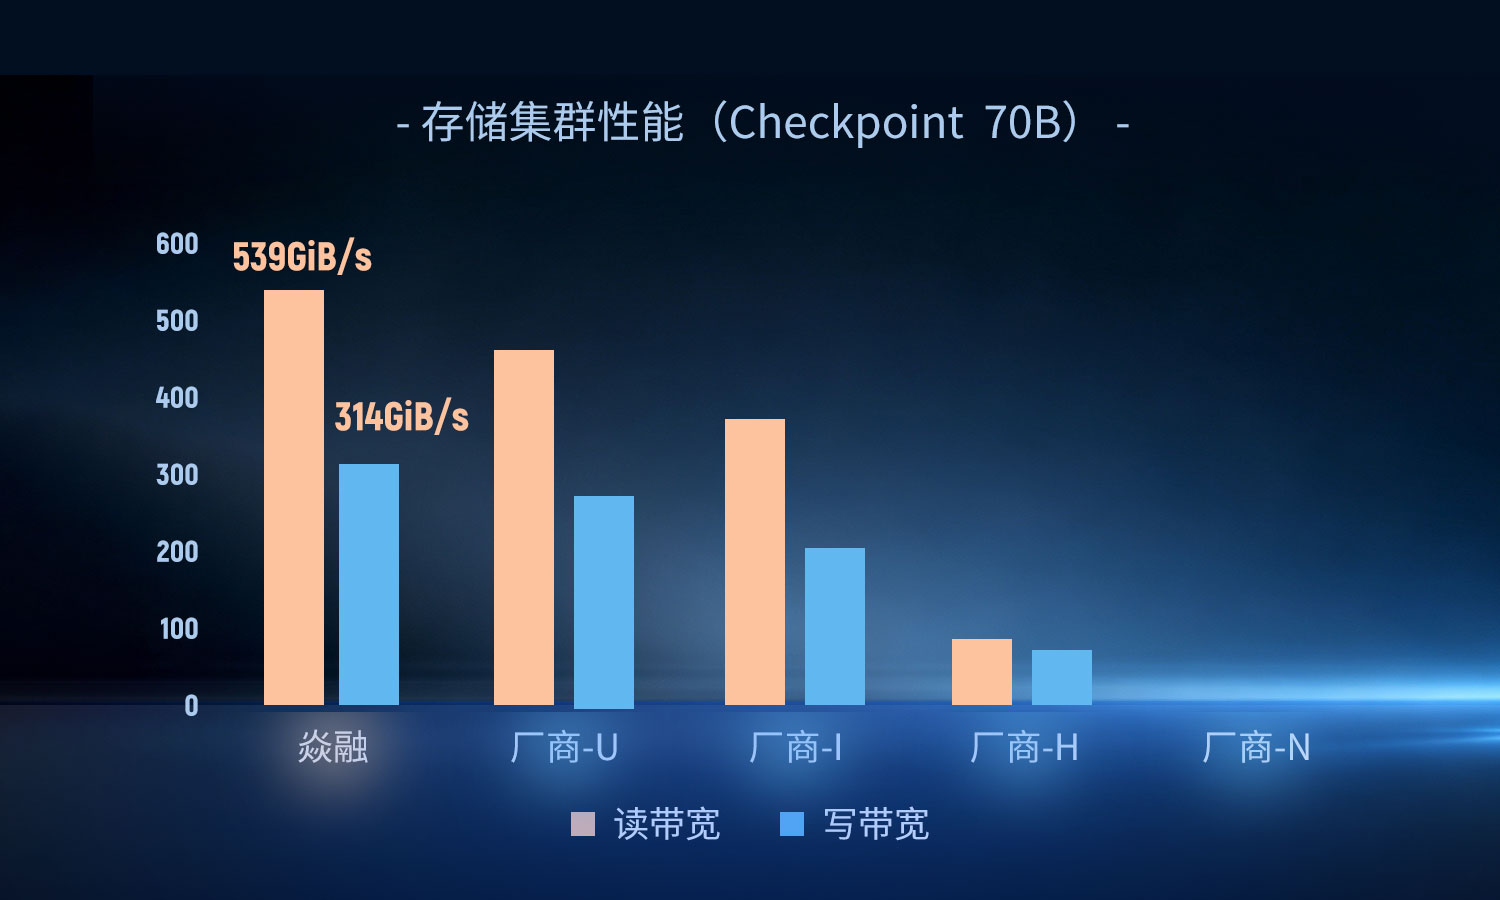
Checkpoint 70B测试:存储集群聚合读写带宽均位列第一
此外,针对 v3.0 新增的 KVCache 推理工作负载,焱融存储同样展现出硬核实力,实测达成读带宽 288GiB/s、写带宽 60GiB/s 的亮眼表现,充分验证了焱融全闪 F9000X 面向大模型推理 KV Cache 高并发数据卸载与快速回读场景的强大 I/O 支撑能力,助力长上下文、高并发推理实现高效运行。
焱融全栈AI存储 持续释放GPU算力价值 加速AI规模化落地
从 MLPerf Storage v1.0、v2.0 到最新的 v3.0,测试的 AI 工作负载不断演进,焱融全栈 AI 存储技术也在持续突破升级 —— 从高性能全闪存储,到 YRCache 推理存储系统,再到 YRCache ContextBox 一体机,焱融科技构建起了覆盖 AI 全流程的数据基础设施能力。而每次 MLPerf 基准测试的结果,也充分证明了焱融存储面向多元 AI 工作负载的技术实力。未来,焱融将持续围绕算力、存力与网络协同,针对 AI 训练、推理及新型数据工作负载不断优化存储基础设施,以高性能、高效率的数据底座释放 GPU 算力价值,助力 AI 应用深入发展。
此次 MLPerf Storage v3.0 测试成绩的取得,也离不开产业链生态伙伴的大力支持。特别感谢英特尔公司为系统提供的关键核心支撑,同时感谢新华三、浪潮、云尖信息、华勤、同泰怡等服务器合作伙伴,以及Solidigm、忆恒创源等企业级 NVMe SSD 和英伟达高性能网络设备对焱融参与本次基准测试提供的硬件支持。未来,焱融也将继续携手生态合作伙伴,持续攻坚 AI 存储核心技术,不断突破性能边界。