近日,工业和信息化部公布第八批专精特新"小巨人"企业名单,北京焱融科技有限公司入选。
此次获评,是对焱融科技十年来专注存储、自主研发核心软件,并将技术成果应用于大规模智算基础设施的认可。
国家级专精特新“小巨人”企业证书
国家级认定 彰显细分领域创新实力
国家级专精特新“小巨人”企业由工业和信息化部认定,是我国优质中小企业梯度培育体系中的最高层级。根据 2026 年施行的《优质中小企业梯度培育管理办法》,第八批新申报企业须已获专精特新中小企业称号,并在特定细分市场深耕至少三年。认定综合考察经营质量、研发投入、与主导产品相关的知识产权及其实际应用、主导产品在细分市场的地位,以及对产业链关键环节的支撑作用。
这些要求体现了专精特新企业的发展方向:在细分领域持续投入,把自主技术转化为有市场竞争力的产品,并用产品解决产业链关键环节的实际问题。
十年深耕存储 持续聚焦高速 AI 存储
焱融科技成立于 2016 年,是一家以自主存储软件为核心的中国独立 AI 存储厂商。公司从软件定义存储起步,自主研发高性能分布式文件系统 YRCloudFile,为大规模计算集群提供高速、稳定的共享文件访问。随着大模型走向规模化训练与推理,焱融沿着同一条技术路线持续投入:从提升训练数据的读写效率,延伸到推理缓存的分层管理与跨节点复用,并进一步覆盖多源数据治理。
在国家算力基础设施建设中,焱融聚焦的是如何让存储更好地服务算力。2025 年,公司入围工信部“算力强基揭榜行动”的“存储调度管理及应用技术”方向,围绕海量数据的可靠存储、按需流动与高效调度开展技术研发。2026 年 3 月,焱融宣布完成由北京信息产业发展投资基金投资的近亿元 C 轮融资,为核心技术研发和产品迭代提供支撑。
从自研核心软件到全栈 AI 存储
作为国内少数具备全栈 AI 存储能力的独立厂商之一,焱融以自研 YRCloudFile 和 YRCache 为基础,形成覆盖模型训练、在线推理和数据治理的产品体系。
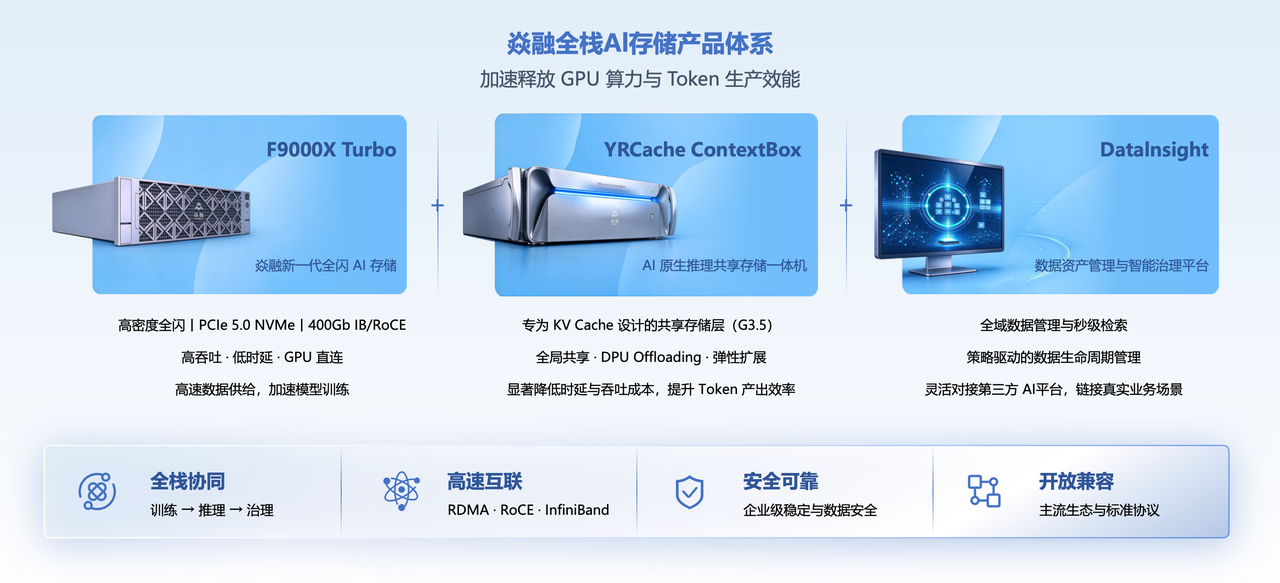
焱融科技打造国内先进的全栈 AI 存储产品体系
-
模型训练|减少 GPU 等待数据的时间
在大模型训练集群中,GPU 需要持续读取训练数据,系统也需要定期写入 Checkpoint,以便在中断后恢复训练。读取跟不上、保存耗时过长,都会影响训练效率。焱融科技与英特尔联合推出的 F9000X Turbo 全闪 AI 存储一体机,面向这两类负载提供高带宽读写能力。在 MLPerf Storage v3.0 基准测试中,焱融 F9000X 三节点全闪集群在 3D U-Net 训练场景实现约 544 GiB/s 聚合读带宽。
-
在线推理|让长上下文在不同节点间复用
在长文档分析、多轮对话等场景中,同一段上下文可能被反复使用。如果请求被调度到其他节点,而已有 KV Cache 仍留在原节点,GPU 就可能重复计算。YRCache ContextBox 在本地 SSD 与远端持久化存储之间提供可独立扩展的共享缓存层,让不同推理节点能够读取并复用已有 KV Cache。在相同 GPU 集群、模型和推理框架下,与 Mooncake Store 池化方案相比,64K 上下文、4 并发、缓存全命中时,首 Token 时延由 8.07 秒降至 0.74 秒。在同一轮测试的高负载饱和区,系统总吞吐平均提升约 43%。
-
数据治理|让分散的数据更容易被 AI 应用使用
企业建设知识库或内部 AI 应用时,业务文档和数据往往分散在不同存储系统中,查找、整理和持续更新都需要投入人力。DataInsight 支持异构数据源的统一管理、快速检索和生命周期管理,并可对接第三方 AI 平台,帮助企业将分散的数据接入知识检索、问答等实际业务。
焱融将持续积累的自研存储能力转化为解决客户实际问题的产品,并已在大模型、智算中心、金融等场景实现规模化应用。
市场认可与生态共建 推动 AI 存储规模化落地
截至目前,焱融全栈 AI 存储已在大模型、智算中心、金融、智能汽车及 AI4S 等场景规模化应用。据 IDC 数据,2026 年上半年,焱融位居中国全闪文件存储市场前三。焱融同时入选《IDC MarketScape:中国人工智能就绪的数据存储基础设施 2026 年厂商评估》。
焱融与 NVIDIA、AMD、沐曦、摩尔线程、燧原等厂商开展技术适配与联合验证,并参与 ODCC 首次 KV Cache 评测结果发布,推动 AI 存储在不同算力平台落地。此次获评国家级专精特新“小巨人”企业,焱融科技将继续深耕核心存储软件,为大规模 AI 训练与推理提供高效、可靠的存力支撑。