KV Cache 已成为当前大模型推理系统优化的核心议题之一。随着长上下文、Agent 和复杂推理任务的快速发展,推理过程中产生的 KV Cache 规模持续增长,对存储容量、访问效率以及系统调度能力提出了新的挑战。如何更高效地管理和利用 KV Cache,正在成为学术界与产业界共同探索的重要方向。此次入选 ICML 的《ProphetKV:面向检索增强生成中高效 KV 缓存复用的用户查询驱动选择性重计算(ProphetKV: Query-Driven Selective Recomputation for Efficient KV Cache Reuse in Retrieval-Augmented Generation)》研究,正是围绕这一关键问题展开。该成果由哈尔滨工业大学(深圳)夏文教授团队与焱融科技联合完成,聚焦 KV Cache 的预测与优化机制。结合这一研究方向,也能够更好地理解焱融科技 YRCache 推理存储系统背后的技术思路,以及其对于推理基础设施演进的探索。
KV Cache 复用正在成为推理优化的核心战场
随着推理负载持续增长,业界对于性能瓶颈的关注也正在从单纯的算力供给扩展到整个数据路径。
在长期服务 AI 训练与推理场景的过程中,焱融科技观察到,越来越多的推理性能问题并非源于 GPU 算力不足,而是来自数据访问、上下文处理以及 KV Cache 管理效率等环节。尤其是在长上下文、RAG 和 Agent 应用中,这类问题正变得愈发突出。
Prefill 阶段的算力黑洞:在 RAG(检索增强生成)、企业知识库和多轮 Agent 场景中,大量的请求在重复输入相同的系统提示词、背景知识或历史对话。虽然这些文本已被模型处理过,但由于缺少全局复用机制,每次新请求进来,系统依然要对成千上万的 Token 重新执行高昂的 Prefill 计算。
计算复杂度的平方级飙升:Transformer 的 Self-Attention 机制决定了其 Prefill 成本会随着上下文长度呈平方级增长。对于长上下文请求,Prefill 占据了绝大部分的首次 Token 延迟(TTFT),导致运营成本严重向“上下文处理”倾斜,而非真正的“内容生成”。
因此,KV Cache 的高效复用成为了当前大模型推理系统优化的绝对核心。
缓存复用最大挑战并非“命中率”
绝大多数团队沿用Redis等传统缓存思维优化KV Cache,采用前缀缓存(Prefix Cache),依靠匹配相同文本前缀实现缓存复用。该模式短板十分突出:仅支持Prompt序列头部完全一致的场景,即使整体的Prompt从语义角度非常相近,也会仅仅因为中间一个字符的差异就导致大量的后续缓存无法被复用,导致缓存利用率存在天然上限。
倘若为拉高缓存利用率,直接将多段独立缓存拼接组合,看似提升缓存利用率,实则会埋下严重隐患:语义失真与精度下降。
为什么 KV Cache 不能简单地“拼积木”? Transformer 的 KV Cache 不仅记录了当前 Token 的信息,还蕴含了它与上下文中其他所有 Token 的 Attention(注意力)权重关系。当系统把几个不同的历史缓存片段、多篇不同的文档片段动态拼接在一起时,它们之间原本的跨文档、跨片段注意力路径是缺失的。
如果为了追求速度而强行“硬拼接”复用,虽然省去了 Prefill 计算,但代价往往是模型无法正确关联上下文语义,导致回答质量劣化甚至开始胡言乱语。如何在不牺牲模型精度的前提下实现深度复用,是当前技术攻坚的焦点。
ProphetKV, 以“查询”为锚驱动选择性重算
面对“性能”与“精度”的鱼与熊掌之争,焱融科技与哈工大(深圳)团队在论文中提出了一个非常惊艳的解法——ProphetKV:引入当前用户的 Query(查询),来进行驱动型的选择性重算。
传统方案(如静态剪枝或固定位置留存)是盲目的,它们在决定保留或废弃哪些 KV 状态时,并不知道用户待会儿要问什么。而 ProphetKV 的核心思想认为:用户的当前提问,就是最好的重要性筛选器。
系统会首先利用用户当前的查询,与全局缓存进行一次轻量的相关性评估,识别出哪些 Token 才是真正影响这次回答质量的关键节点。随后,在有限的算力预算内(比如仅拿出 20% 的预算)对这些关键 Token 进行局部重算。
实验数据表明,这种方式不需要对数十万字的长上下文重新做一遍完整的 Prefill,在仅消耗 20% 重算预算的情况下,就能找回接近 100% 的全量 Prefill 精度,同时让长上下文场景下的 TTFT(首次 Token 延迟)获得最高接近 5 倍的暴击式加速。
从 ProphetKV 到 YRCache 的完整技术闭环
要将上述算法真正落地到高并发的推理生产线,不能仅靠单一的优化算子。焱融科技与哈工大(深圳)联合构建了一套完整的上下文复用框架,并将其逐步沉淀到 YRCache 产品体系之中,实现了从识别到管理再到执行的完整闭环:
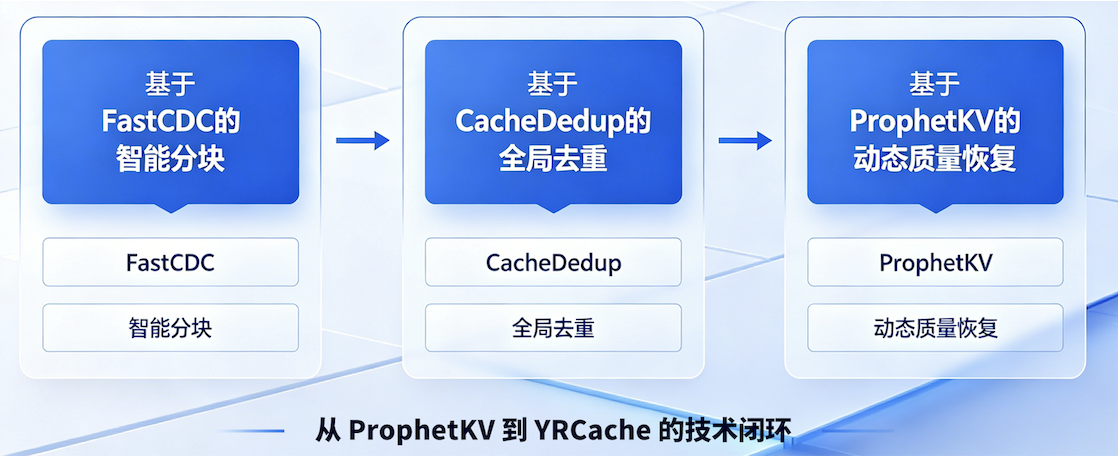
首先是基于 FastCDC 的智能分块。系统放弃了生硬的固定长度切分,引入了内容定义分块(Content Defined Chunking)技术。这意味着,即使文档被调整了顺序、或者中间插入了新字,系统也能跨越位置变动,敏锐地识别出其中的重复内容,为更广泛的缓存复用创造了先决条件。
其次是基于 CacheDedup 的全局去重。通过内容哈希、元数据校验以及高效的缓存索引机制,系统把已经生成的 KV Cache 真正沉淀下来,构建起一个可跨请求、跨会话共享的分布式缓存池。在线上测试中,实际重复片段的检出率超过了 95%。
最后是基于 ProphetKV 的动态质量恢复。在运行时,系统结合前面提到的“查询驱动”策略,在有限的显存与算力预算下,动态调度需要重算或者换入换出的缓存节点。在极限压榨性能的同时,精准找回流失的语义精度。
YRCache:构建可共享能复用的推理缓存底座
随着大模型 Serving 架构全面演进为 Prefill-Decode 分离(预流-解码分离架构),厂商们面对的 KV Cache 早已不再是某个 GPU 显存里的临时高频数据,而是一种全新的数据资产。
如果说 ProphetKV 解决的是算法层面上“哪些 KV 值得重新计算”的问题,那么 YRCache 解决的则是工程层面上“如何让 KV Cache 成为可管理、可共享、可复用的数据基础设施”。AI 厂商在通过 YRCache 重构其推理底座时,可以全面升级以下工程能力:
斩断“KV 传输税” (KV-Transfer Tax):
在分离架构下,Prefill 节点把缓存算完后,需要通过高速网络传输给 Decode 节点。如果 KV Cache 体积过大,网络传输耗时甚至会超过它所节省的计算时间。YRCache 凭借焱融在高性能存储领域的深厚积累,构建了从 GPU显存、主机内存到 NVMe闪存的多级存储冷热层级调度体系,大幅优化了换入换出(Swap-in/out)的效率。
全生命周期的资产管理:
在线上高并发、多租户的场景下,YRCache 提供了多租户缓存管理、分布式缓存调度以及与主流推理框架的深度集成。它让 KV Cache 能够安全隔离、高效索引并自动化淘汰,从而真正盘活了推理集群的资源利用率和 Token 生产效率。
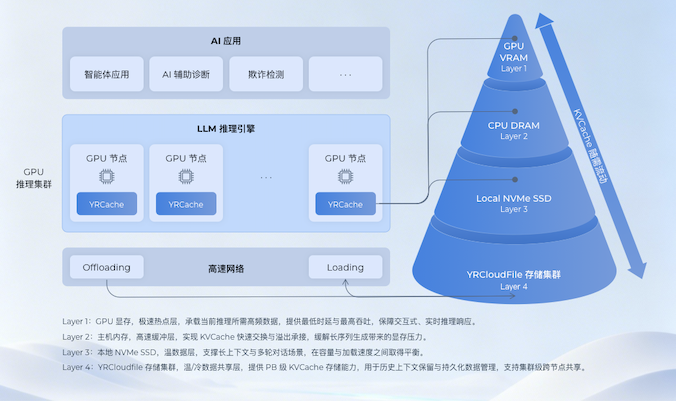
YRCache 架构图
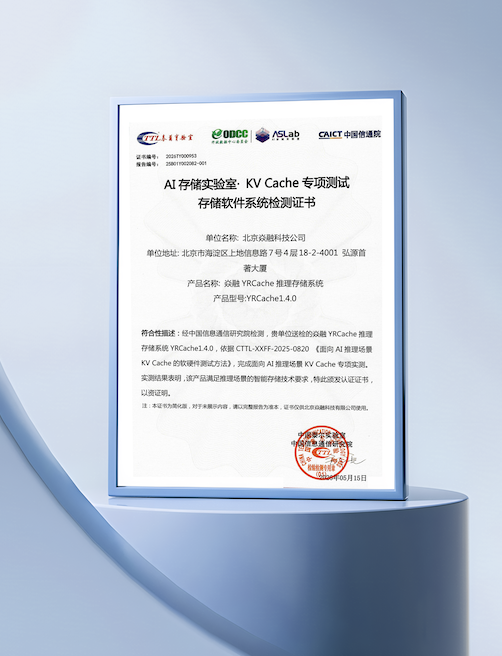
这套工程能力的落地价值,已在ODCC(开放数据中心委员会)AI存储实验室首批KV Cache测试中得到权威验证,为市场树立了标杆,为行业发展提供了参考与借鉴。
推理性能实现数量级提升
在中端 GDDR GPU 服务器、10K Token 输入场景下,集成 YRCache 后 TTFT 降低 97%,TPOT 降低 97%,Token吞吐量提升 22 倍。
长上下文场景保持稳定优势
随着输入 Token 长度从 100 扩展至 100K,YRCache 的性能增益呈现放大趋势。
跨越硬件代差的成本革命
在 YRCache 加持下,中端 GDDR GPU 的综合推理性能接近高端 HBM GPU,投资回报率(ROI)提升 14 倍。
这些数据也反映出一个重要趋势:当推理瓶颈从计算逐步转向 IO 时,存储系统正在从“数据底座”演变为决定推理效率与成本结构的核心变量。
展望
大模型推理的下半场竞争,拼的是每微秒的延迟和每一分钱的 Token 成本。
GPU 负责计算,模型负责生成,而数据系统则决定了这些计算资源是否能被高效利用。优化 KV Cache 不仅仅是写一个更快的 CUDA Kernel,而是要建立起一套融合了算法语义理解与分布式数据系统的全新推理数据基础设施。焱融 YRCache 在这一方向上的长期投入,正成为推动 Token 经济持续演进、帮助 AI 厂商降本增效的核心底座。