线上请求平均输入长度 77K Token、首 Token 响应时延(TTFT)平均低至 400 毫秒、输入缓存命中率 96%,计入缓存命中 Token 后的 Prefill 每卡输入吞吐达到未计入时的 25 倍,整体服务收入按特定定价口径折算约 38 美元/卡时。
这一组来自 DeepSeek 大规模推理生产环境的数据,展现了其在长上下文、高并发场景下的系统级优化能力。2026 年 10 月 20 日,DeepSeek 正式开源支撑其线上服务的高性能推理引擎 DeepInfer,也让外界得以进一步了解其背后的技术体系。透过它,一个趋势被清晰地摆到行业面前:当大模型推理迈入长上下文与 Agent 时代,决定性能的早已不只是 GPU 算力本身——KV 缓存如何存、如何复用,存储与缓存架构正在成为新的胜负手。
然而,DeepSeek 验证了一条技术路线,但这并不意味着所有企业都能轻松复制。
一方面,由于其内部基础设施耦合过深而并未开放 DeepInfer 全部能力;另一方面,DeepSeek 服务于超大规模生产集群的推理存储系统,也并非能轻易复制。对于缺少大规模基础设施研发能力的企业而言,如何以更低的部署复杂度和资源投入,构建高性能、可扩展的共享 KV Cache 存储体系,仍是一道现实的工程难题。
本文将深入拆解 DeepSeek 架构中的 KV Cache 存储逻辑,并探讨焱融 YRCache ContextBox 推理存储一体机如何帮助每一家企业跨越底层基础设施的工程鸿沟,通过更轻量、低投入“开箱即用”的方式快速复刻 DeepSeek 的高效 Token 生产力。
先看核心逻辑:为什么KV Cache决定长上下文推理的生死?
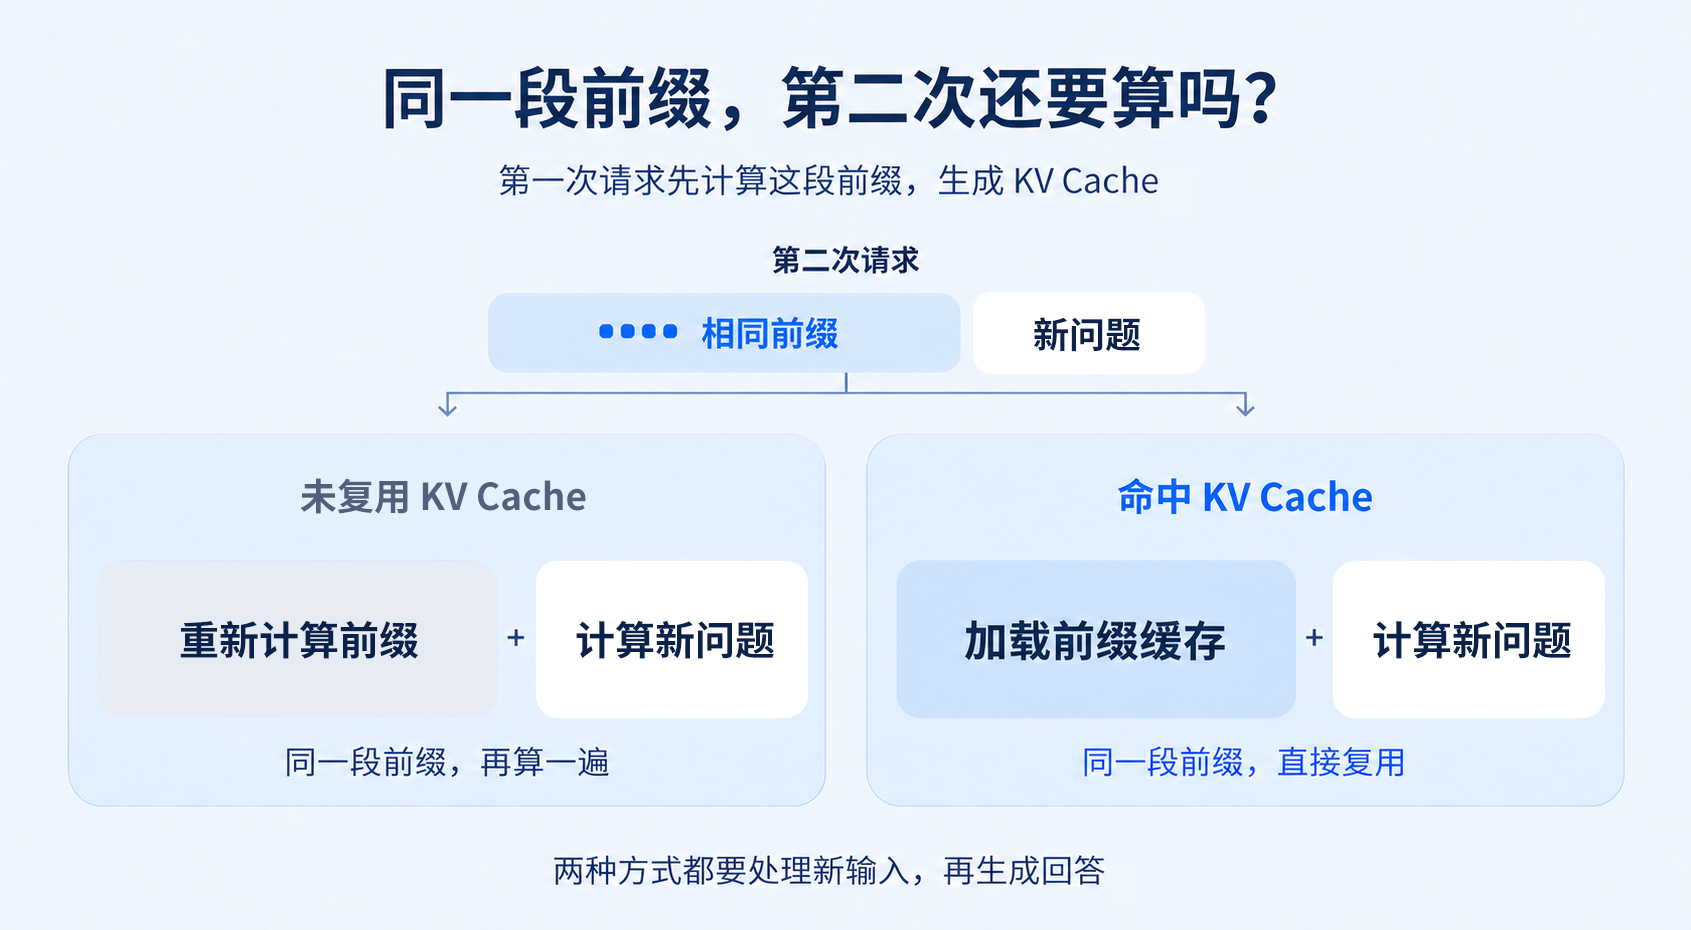
模型处理输入上下文时,会把历史 Token 在注意力层算出的 Key/Value 中间结果存下来;当后续轮次或新请求带着相同前缀(比如固定的 System Prompt、工具定义、长文档背景或历史对话)进来时,直接读取 KV 缓存即可,不必从头再算一遍。
如果缺少有效的缓存复用机制,推理系统在长上下文和 Agent 场景下会面临两个直接痛点:
- Prefill 算力浪费:每次请求都重新对长前缀做 Prefill(预填充)计算,大量 GPU 算力消耗在重复计算上,不仅吞吐受限,TTFT 也难以压低。
- 调度与容量的两难:如果 KV Cache 只能放在单机显存或单机内存里,一方面容量和留存时间有限,长尾前缀很快被挤掉;另一方面,为了命中本地缓存,调度器往往必须把同一用户的后续请求“死死绑在”同一台机器上,结果就是“前缀亲和”和“集群负载均衡”打架——部分节点过载排队,其他节点却算力闲置。
DeepSeek 验证了的方向:让 KV 缓存成为集群级共享资源
从整体推理架构来看,一套现代生产级推理系统通常涵盖应用层、推理服务与调度层、推理引擎层、KV Cache 管理与加速层,以及多级 KV Cache 存储体系等五个核心层级。
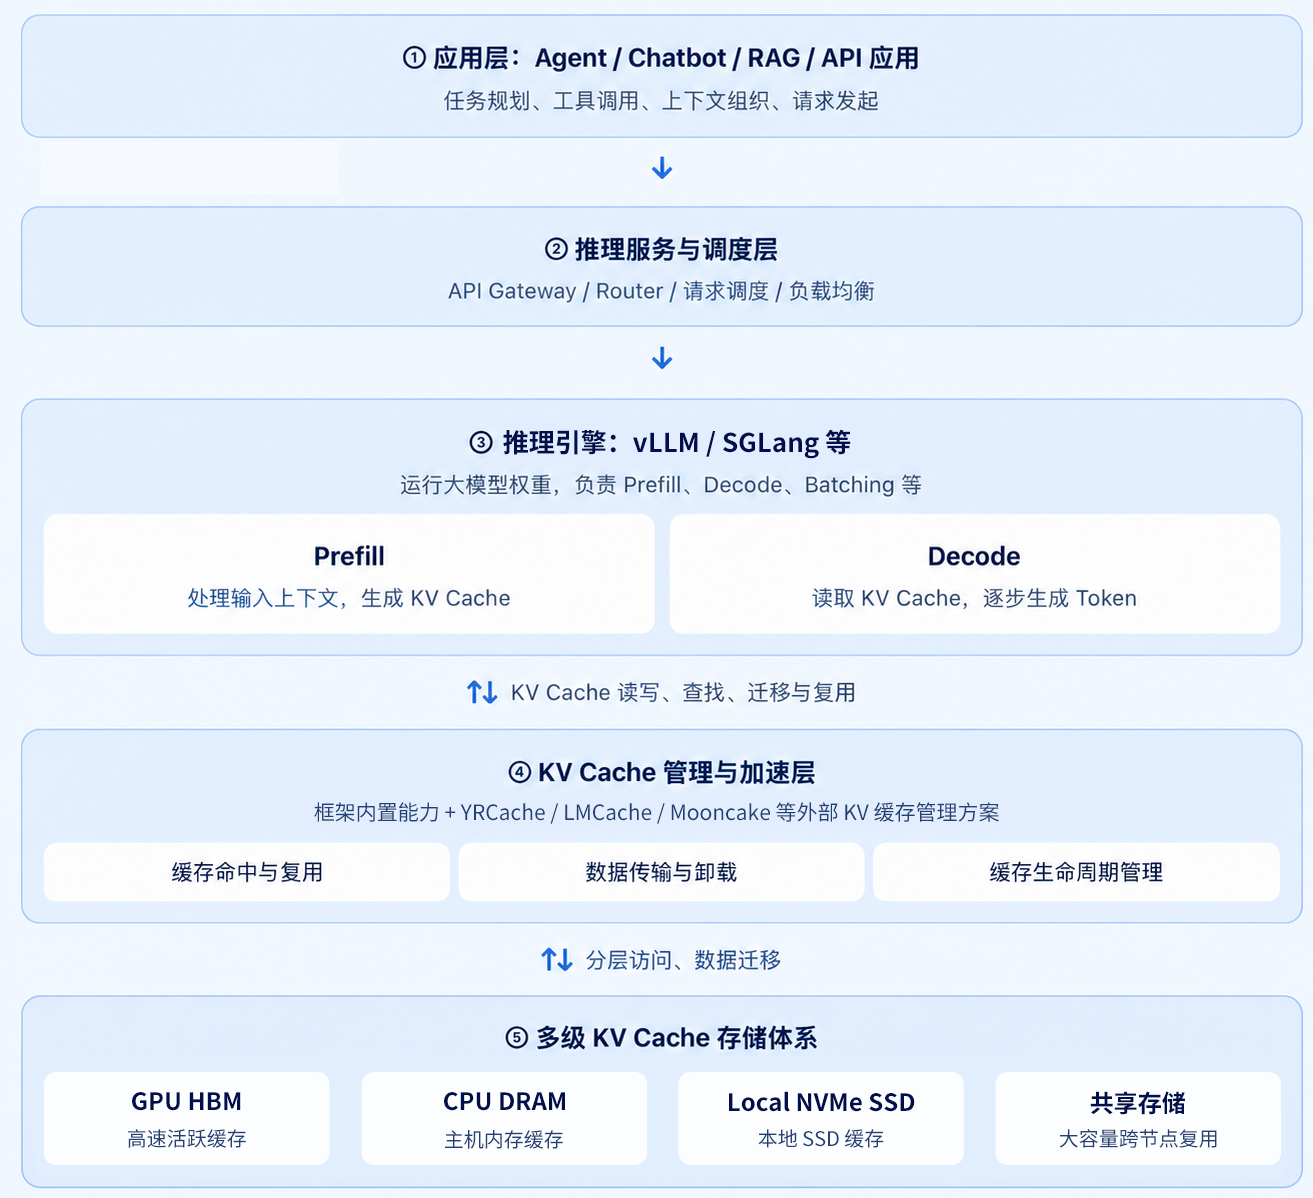
DeepSeek 在计算侧将 Vision Encoder、Prefill 与 Decode 分离部署,并结合 MLA、KV Cache 压缩、专家并行与异步调度等手段提升单步计算效率;而在缓存侧,它打通了第 4 层与第 5 层的协同,构建了三级 KV 缓存体系,把不同生命周期和访问特征的数据分层存放:
- GPU 显存:保存正在执行请求的 KV Cache,供模型计算快速访问,带宽极高,但容量与成本决定了它不适合长期沉淀海量历史上下文。
- 主机内存:承载部分滑动窗口注意力(SWA)等缓存,按需配合高速网络访问,其容量依然有限。
- 独立 3FS 存储集群:承载可长期留存、跨节点复用的大规模分页 Block KV Cache,成为集群级共享缓存池。
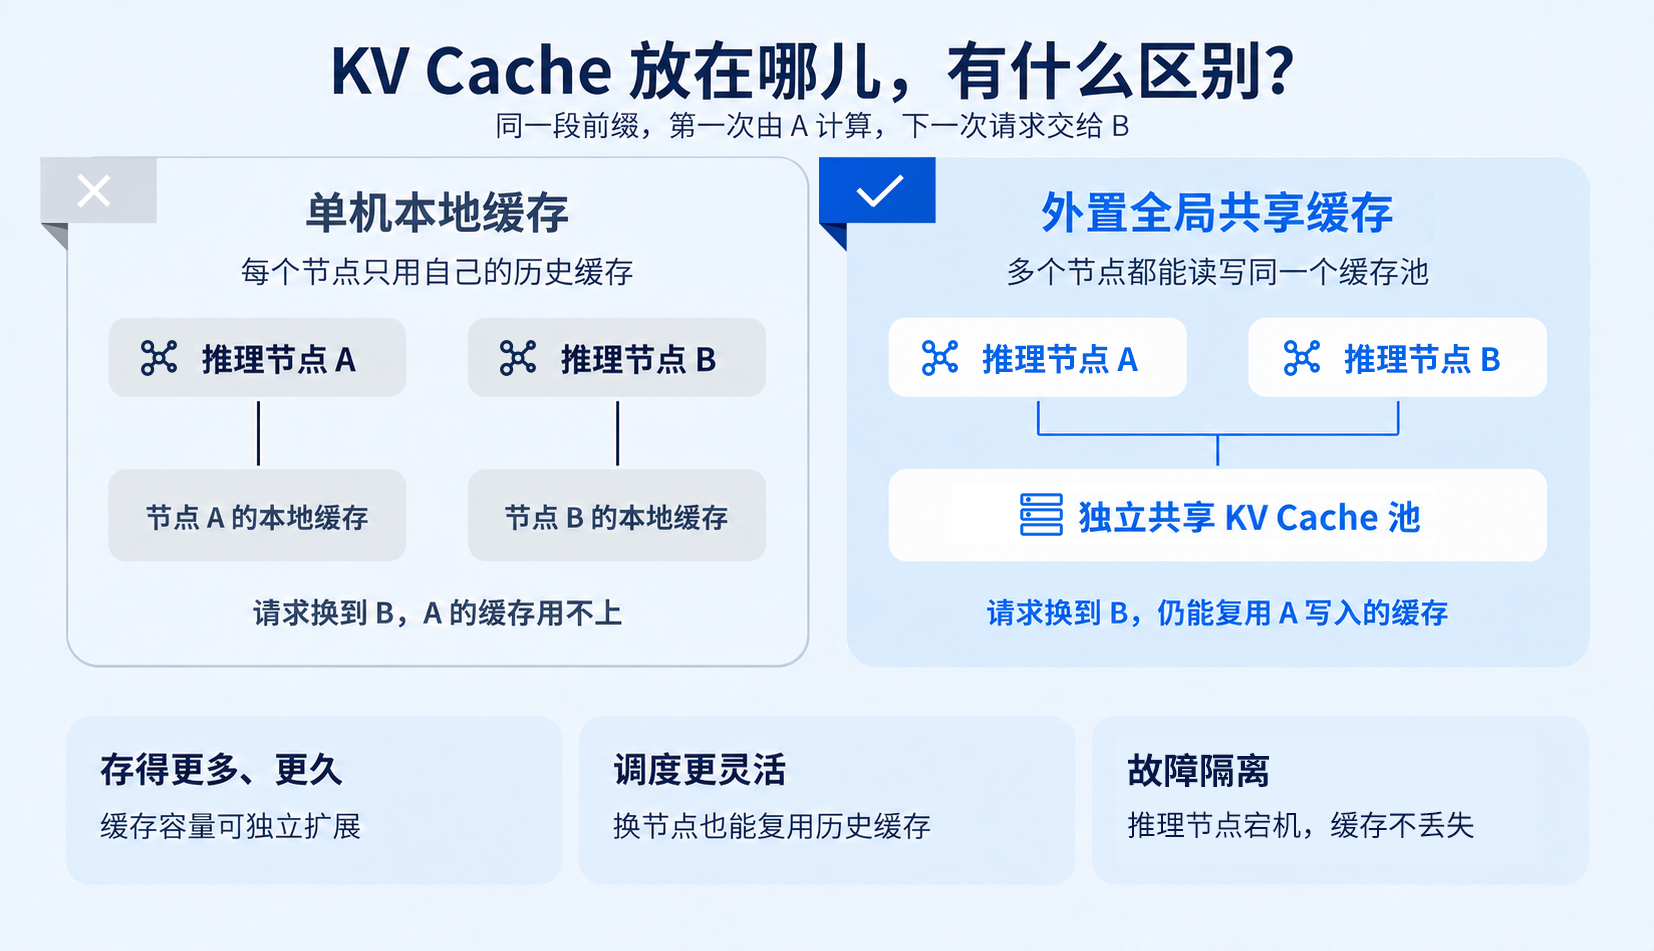
DeepSeek 这种将算过的历史 KV Cache 剥离出计算节点,沉淀进独立的外置全局共享存储池中,带来了三大不可替代的架构红利:
- 打破容量墙与时间窗口限制:跳出单机显存/内存容量限制后,DeepSeek 将线上 KV 缓存保留时间拉长至 72 小时以上(聊天流量留存 7 天),平均每张在线 GPU 背后对应高达 14.4 TB 的逻辑缓存容量,兜住长尾请求的重复命中。
- 释放集群调度自由度:缓存外置成全局共享池后,任意 Prefill 节点都能直接读取并命中历史前缀缓存,调度器不再被单机本地缓存绑架,集群负载均衡更容易做好。
- 算存资源独立扩缩容与故障隔离:存储与计算解耦后,单台推理节点宕机重启不会导致历史上下文缓存丢失,线上连续性与高可用性显著提升。
根据 DeepSeek V4.1 Flash 线上系统的实测数据,这套系统单集群日均处理 155 万亿 Token,输入缓存命中率 96%,命中后吞吐从 6 万 Token/s 跃升至 150 万 Token/s。
当然,这些收益并非存储一项之功——它是 MLA、KV Cache 压缩、调度优化、PD 分离等多项技术叠加的系统性结果,存储是其中被验证的关键一环。但 DeepSeek 的真实生产流量,已经为整个 AI 基础设施行业完成了一次极具说服力的验证:多级 KV 缓存、独立全局共享 KVCache 存储这条路,已被头部厂商的生产系统真正跑通。
DeepInfer 开源了,但企业复刻门槛高
方向被验证,不等于能照着做。DeepInfer 虽已开源,但对于广大希望复刻这一高效推理架构的企业而言,落地过程依然横亘着现实鸿沟:
- 开源缺口——缓存与调度系统要自己配
DeepSeek 官方坦诚指出,由于与内部基础设施耦合太深,KV 缓存系统以及跨副本负载均衡等并未包含在本次开源中。正如业内技术分析所言:“DeepInfer 现在是一台强力发动机,但 KV 缓存与调度方案要自己备。”
- 工程——百 PiB 级自研系统复制不起
DeepSeek 依托 3FS 构建的是约 100 PiB、10+2 纠删码、多节点并行的超大规模共享缓存,是重度定制的内部设施。对多数缺乏专门存储研发团队的企业而言,自研并长期维护这套系统,工程复杂度与人力、硬件投入都过高。
- 成本——传统存储方案在推理场景下“太重、太慢、太贵”
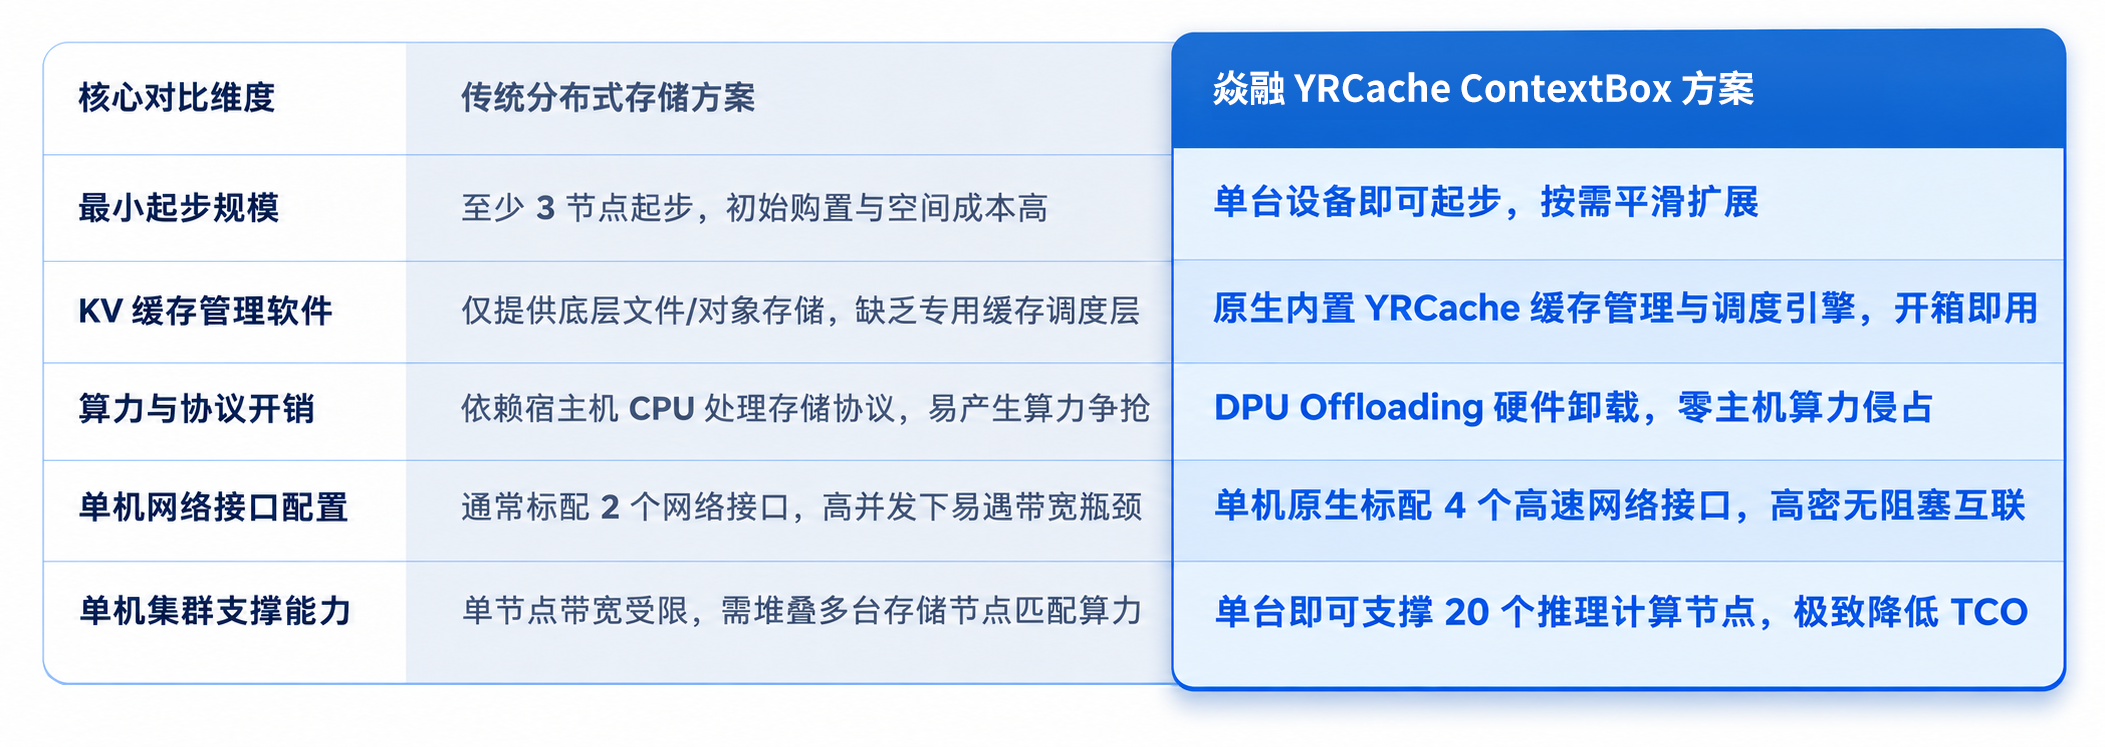
用传统分布式存储搭建共享 KVCache 池的成本与复杂度极高:受限于多副本或纠删码机制,至少需要 3 节点起步,投入高;单台设备通常配备 2 个网络接口,在高命中率带来的海量并发读取压力下极易成为网络带宽瓶颈,且依赖宿主机 CPU 处理存储协议会严重抢占推理计算资源。
焱融 YRCache ContextBox:“开箱即用”的共享 KVCache 存储
针对规模化推理对 KV Cache 容量、共享复用和高效访问的需求,中国独立全栈 AI 存储厂商焱融科技推出 YRCache ContextBox AI 推理存储一体机。其技术方向与 DeepSeek 基于 3FS 构建的外部共享 KV Cache 体系高度一致:将可复用的上下文缓存从 GPU 计算节点中解耦,构建全局共享缓存资源。不同之处在于,它通过软硬件协同优化,将这种需要多组件集成的重型系统,变成了“开箱即用”的一体机。
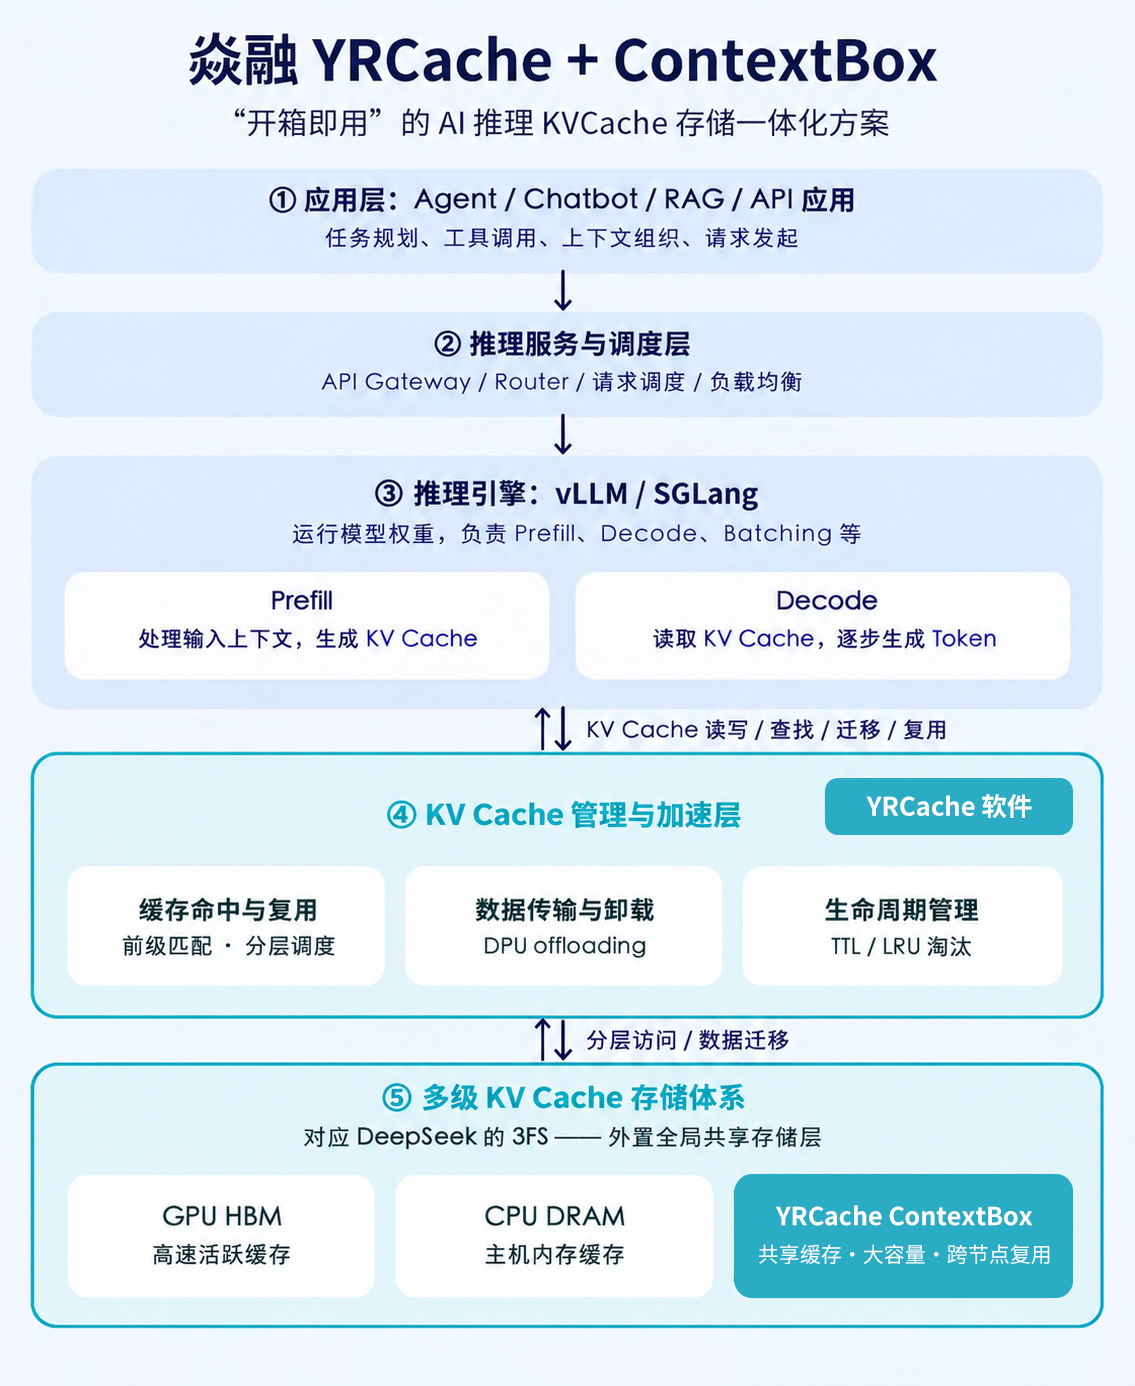
- 内置 YRCache 智能软件栈,填补开源引擎缓存与调度缺口
YRCache ContextBox 集成了焱融自研 YRCache 缓存管理与调度软件,提供全局前缀命中索引、高并发异步卸载与预取、多级缓存调度及全生命周期管理机制,并兼容 vLLM、SGLang 等主流推理引擎及各类异构算力平台,让企业无需修改底层代码即可拥有头部大模型厂商的 KVCache 复用能力。
- 单台设备即可起步,贴合中小与渐进式集群演进
不同于 3 节点起配的重资产模式,YRCache ContextBox 单台设备即可部署落地。无论是万卡级大规模推理集群,百千卡级的中小规模集群,还是起步阶段的 AI 业务探索,都能以极低的初始硬件投入快速搭建起共享 KVCache 缓存池,并随业务增长实现平滑的横向扩展。
- DPU Offloading,零主机算力侵占,压低端到端时延
当缓存命中率升高后,系统压力会从单纯的算力计算转向高频的缓存读取与数据搬运。YRCache ContextBox 采用 DPU Offloading 架构,将存储协议处理、高速网络数据传输和缓存路由计算卸载到 DPU 硬件执行,稳住端到端时延的同时,几乎零消耗推理计算节点 CPU/GPU 资源,确保每一分算力都用于 Token 生成。
- 单机标配 4 路高速网口,单台可支撑 20 节点推理集群
相比传统存储 3 节点起步,单机 2 个网口的高组网与设备成本,YRCache ContextBox 单台设备提供 4 个高速网络接口,构建高密、无阻塞的数据传输通道,单台设备可稳定支撑 20 个推理计算节点的并发访问,大幅简化数据中心组网拓扑,将单 Token 推理综合成本(TCO)压至行业新低。
DeepSeek 用实实在在的线上流量证明了一件事:大模型推理的下半场,拼的不再是单点算力的堆砌,而是系统工程与存储架构的深度协同。焱融 YRCache ContextBox 要做的,就是帮每一家企业跨越底层基础设施的工程鸿沟,把这条已被头部大模型厂商跑通的路,铺成一条能够快速落地、低投入复用的通路。