9 月 22 日,焱融科技联合 Intel 正式发布新一代全闪 AI 存储一体机 F9000X Turbo。面向大规模 AI 核心工作负载,F9000X Turbo 在性能、容量密度与成本效率方面全面升级,以高速、稳定的数据供给持续释放 GPU 算力,为企业构建更高性能、更高效率、更优 TCO 的高速 AI 数据底座。

9 月 22 日,2026 英特尔技术创新与产业生态大会(Intel Connection 2026)在苏州举行。作为英特尔在 AI 存储领域的长期合作伙伴,焱融科技受邀登上大会主会场 Connection 主题演讲舞台。现场,焱融科技 CTO 张文涛重磅揭晓新一代全闪 AI 存储一体机 F9000X Turbo。
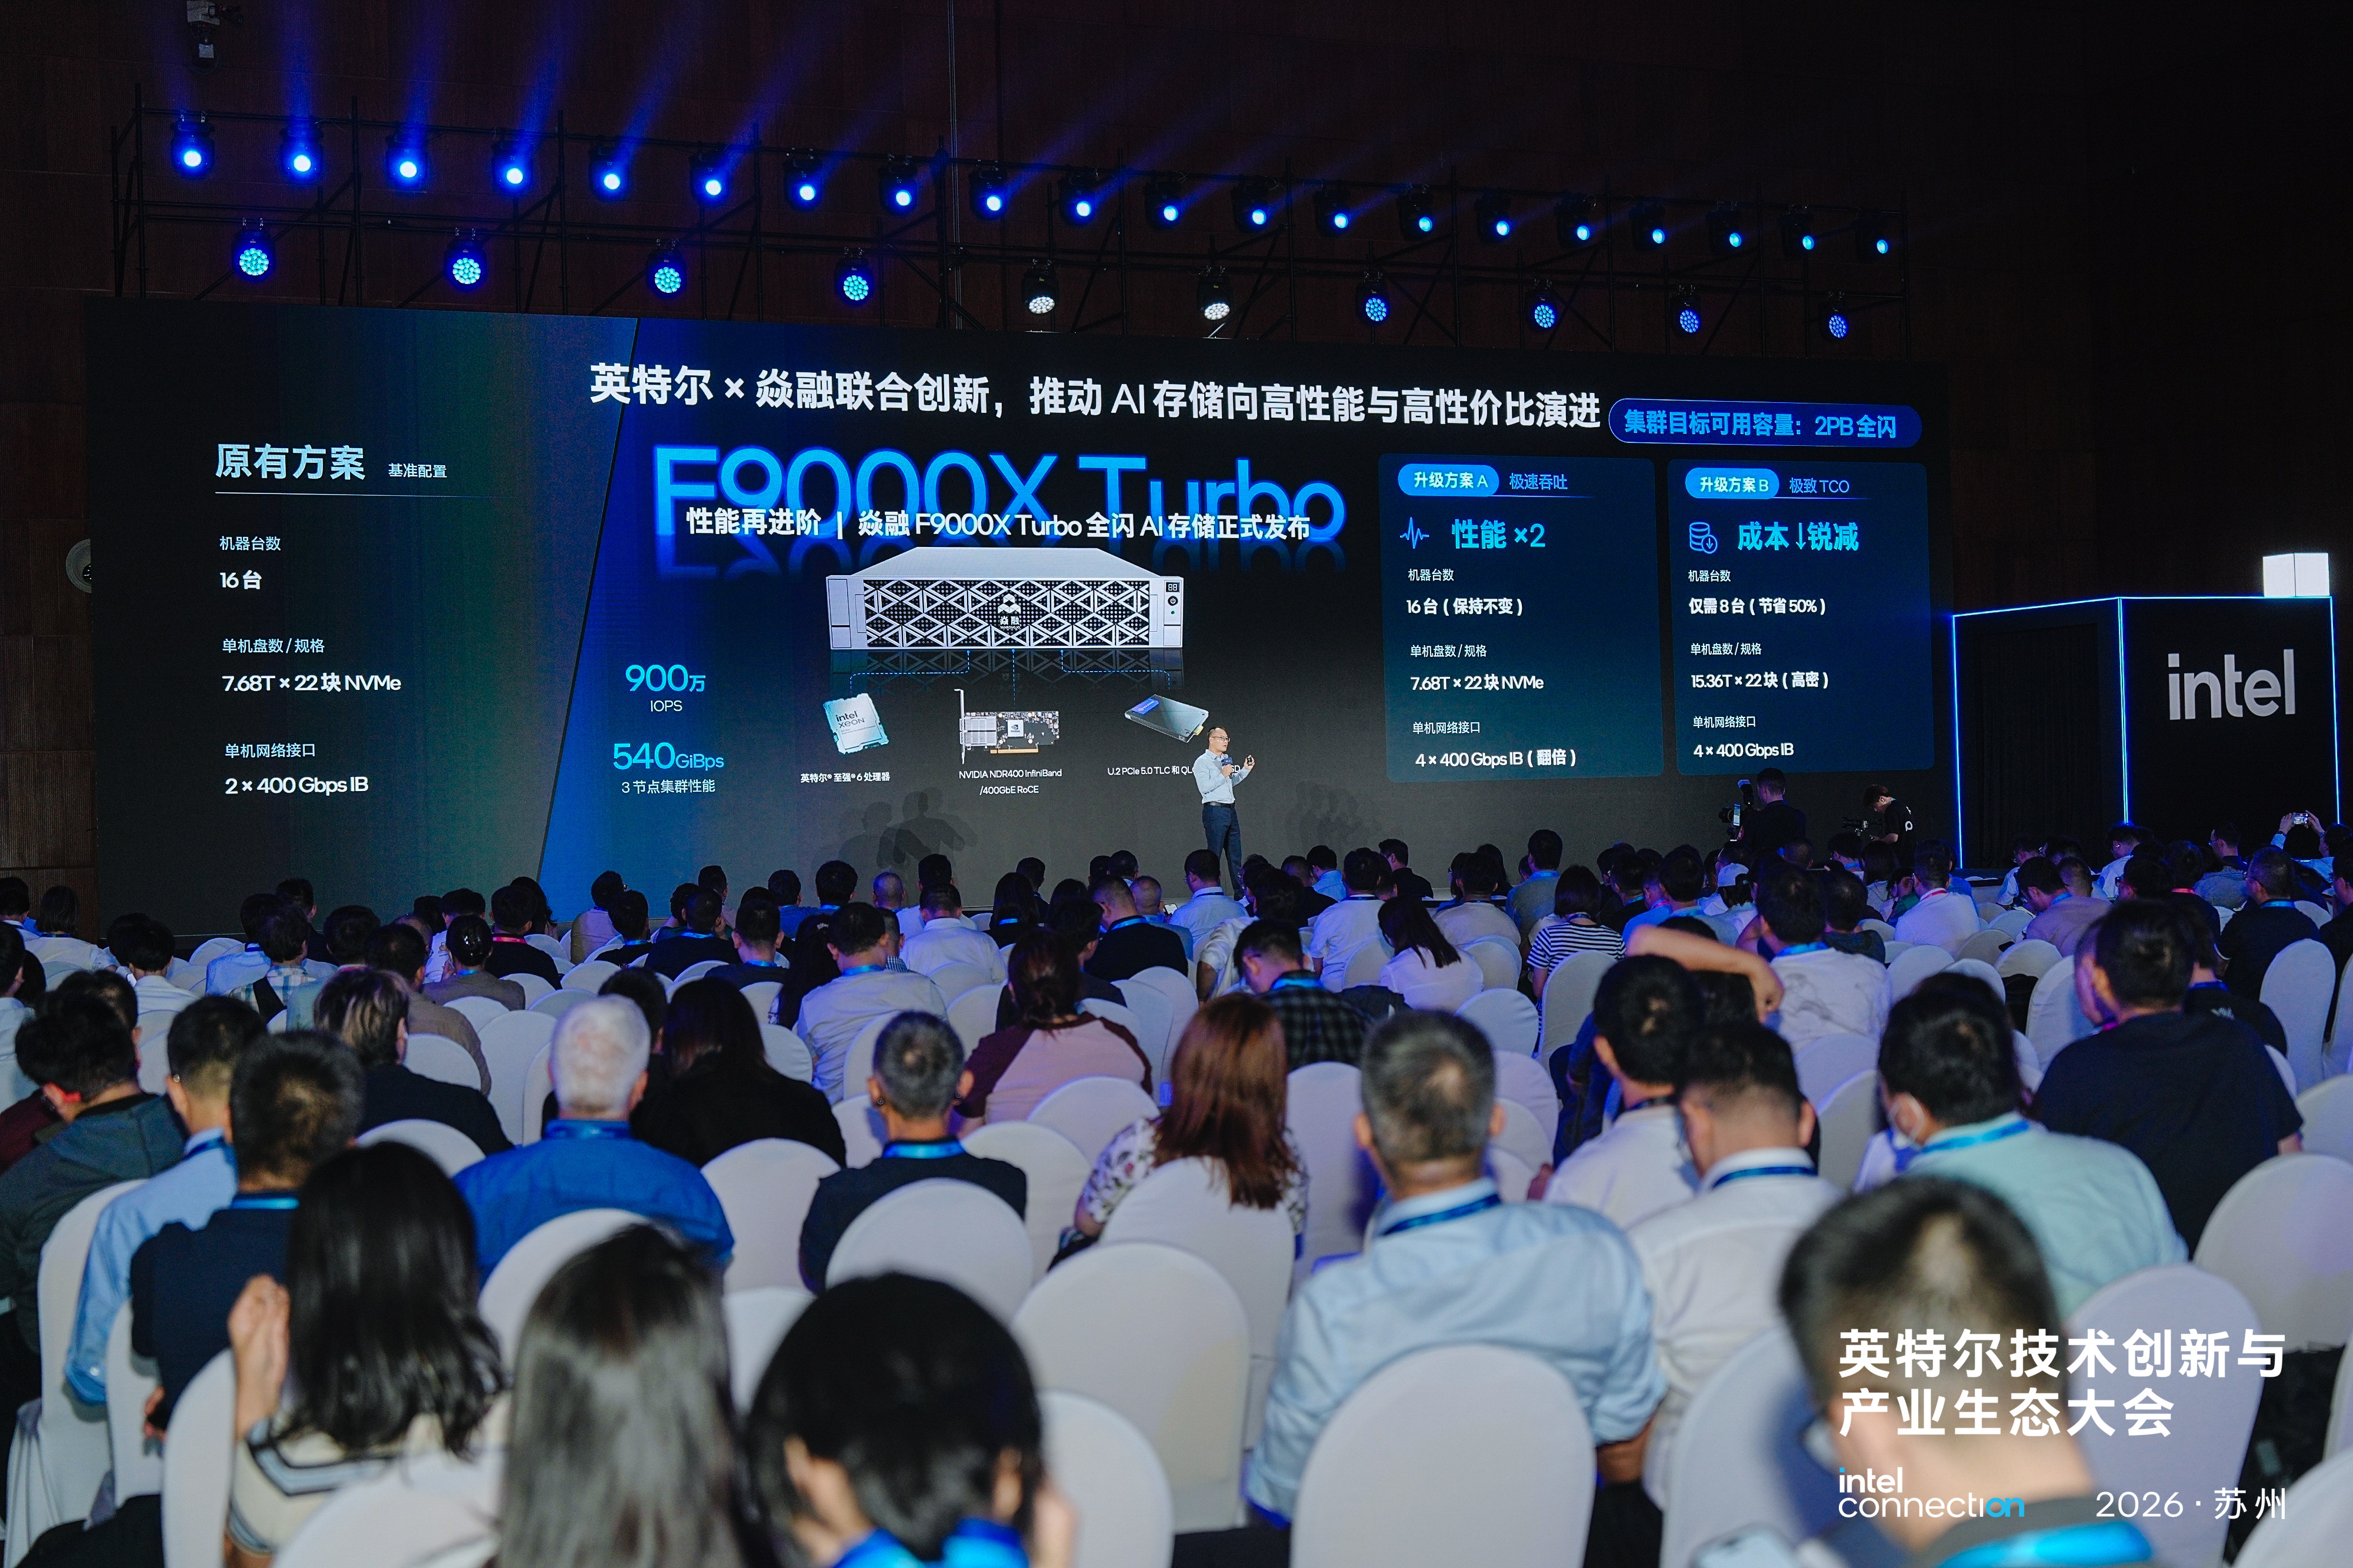
焱融科技 CTO 张文涛正式揭晓 F9000X Turbo
专为大规模 AI 核心工作负载打造高性能数据底座,F9000X Turbo 依托处理器、高速网络、全闪介质与焱融自研分布式存储软件的深度协同优化,实现高密度全闪、更高性能与更优成本效率的多重突破。凭借极速数据供给能力,F9000X Turbo 消除海量并发场景下算力节点的 I/O 瓶颈,减少计算资源等待,让每一张昂贵的 GPU 都能持续满负载运行,为大模型全生命周期的高效演进注入强劲动力。
软硬协同全面进阶,为大规模 AI 提供高速数据底座
F9000X Turbo 是焱融科技与 Intel 在 AI 数据基础设施领域联合创新的最新成果。围绕 AI 工作负载不断提升的数据吞吐需求,双方持续进行协同优化,探索在通用 x86 架构上实现更高性能、更高密度与更优成本效率的 AI 存储基础设施。
F9000X Turbo 延续焱融面向 AI 场景打造的高性能分布式 AI 原生存储架构,并在关键硬件平台上进一步升级:搭载第 6 代英特尔® 至强® 处理器平台,结合 PCIe 5.0 NVMe 全闪介质,并配备 400Gbps InfiniBand / RoCE 高速网络扩展。
软硬一体的深度调优,大幅提升了单节点及集群吞吐能力。仅靠 3 节点集群配置,F9000X Turbo 即可实现 540 GiB/s 聚合带宽,900 万 IOPS 的强悍性能,充分满足 AI 核心工作负载对高吞吐、高并发数据访问的需求,高效支撑海量小文件访问、大规模 Checkpoint 高速读写及海量张量数据供给。
更少节点 · 更强存力 · 更优 TCO
在大规模 AI 基础设施建设中,性能是基础门槛;而随着集群规模扩张,服务器数量、机柜占用、网络布线等综合投入也同步增长,如何在保障性能的同时,优化整体成本,成为客户越来越关注的因素。围绕不同业务诉求,F9000X Turbo 提供了更加灵活的部署选择,实现性能与总体拥有成本的双向平衡。
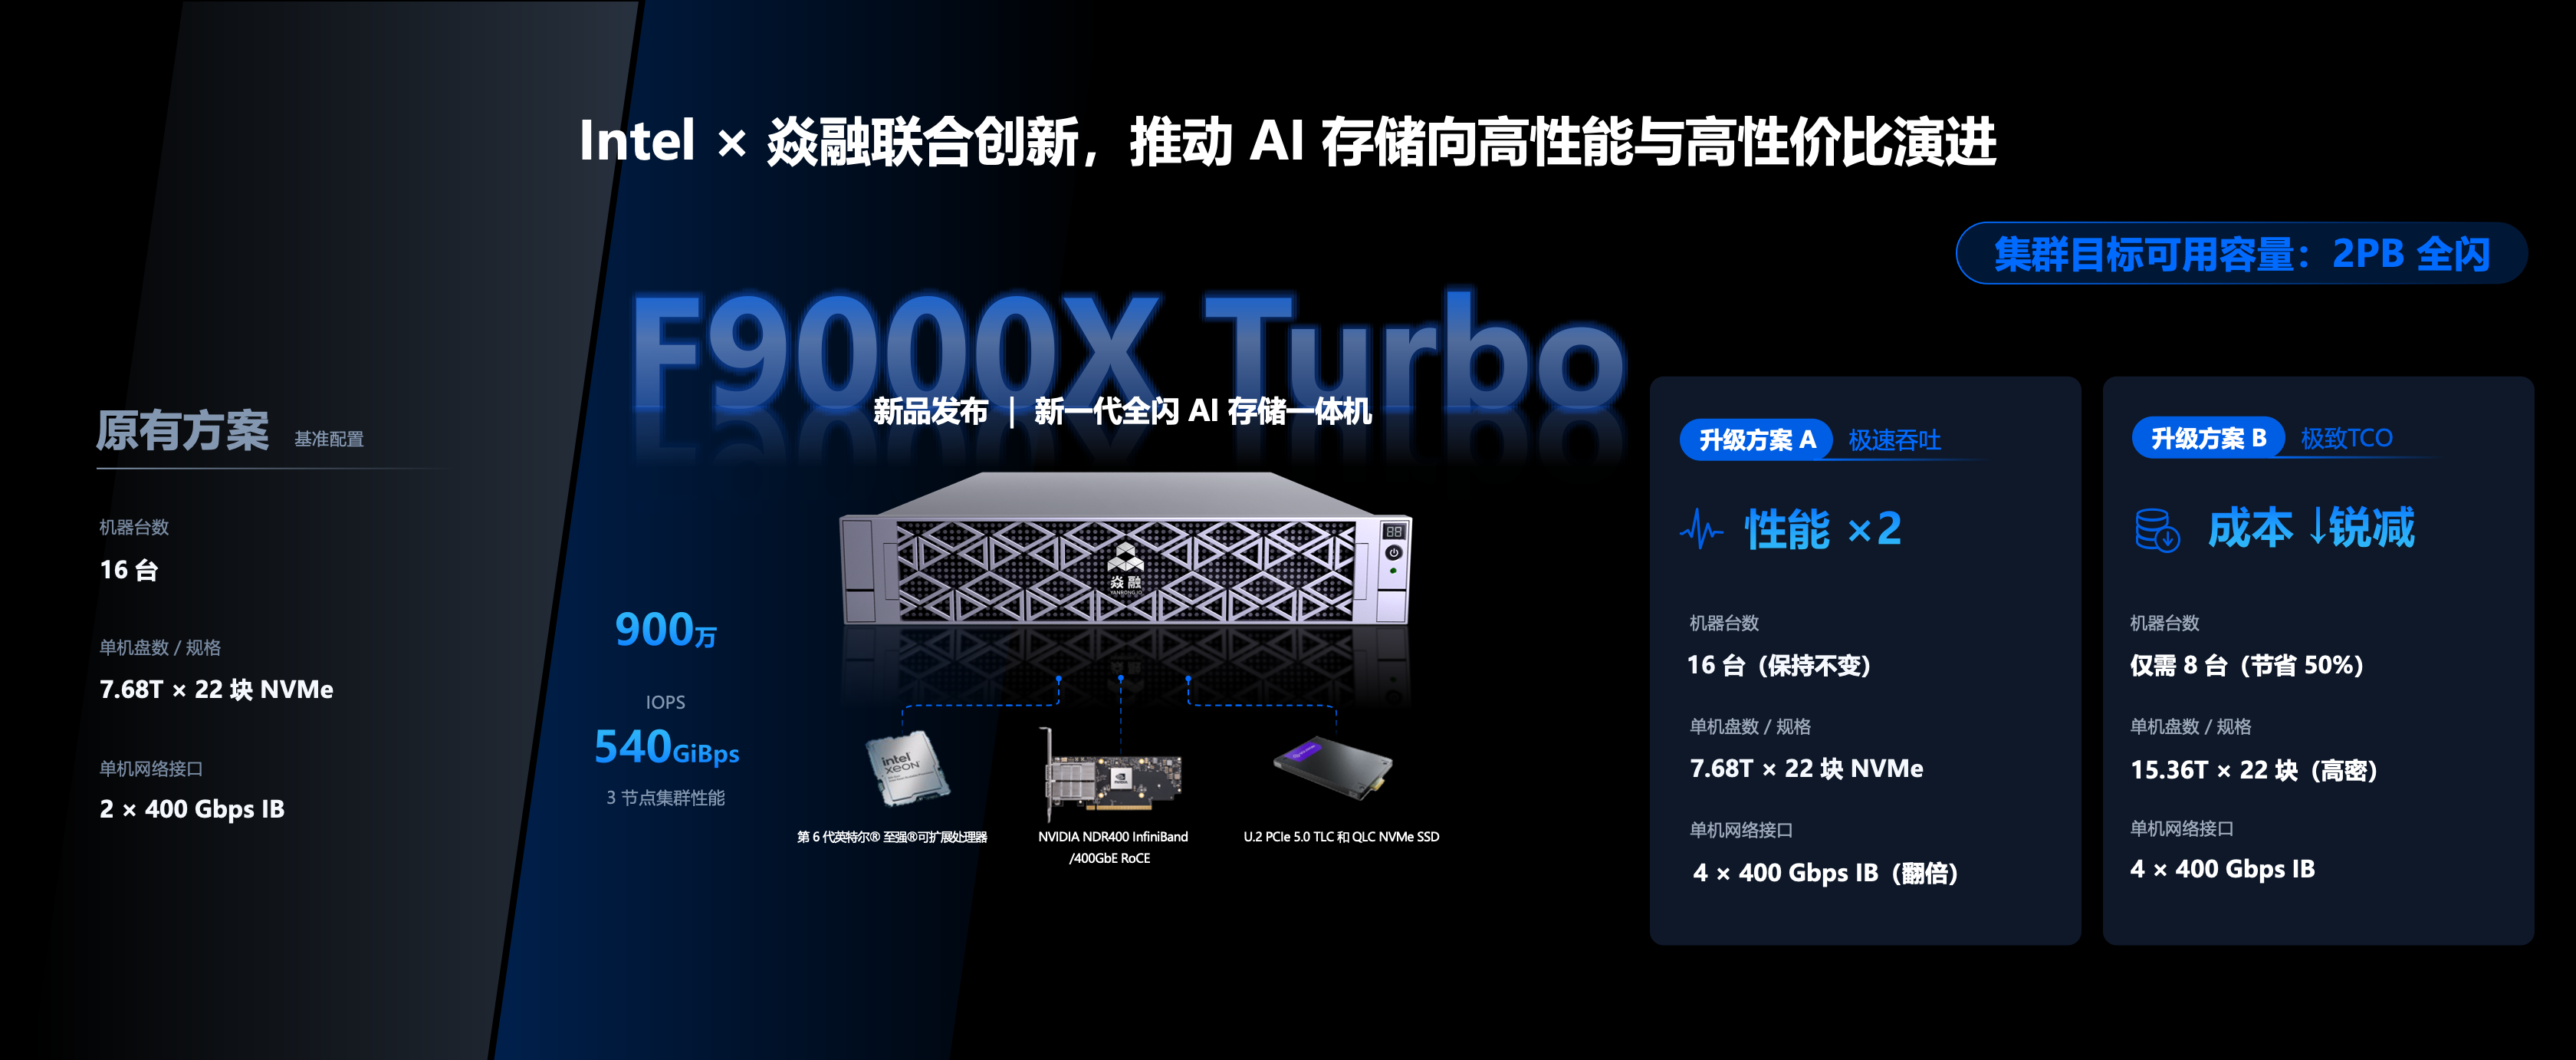
以建设 2PB 全闪可用容量为例,上一代全闪方案单机配置 22 块 7.68T NVMe SSD以及 2 块 400Gbps IB 网卡,需要16 台设备。基于 F9000X Turbo,可以针对不同目标选择两种升级路径:
-
在追求更高性能的场景下:在保持节点规模不变的情况下,F9000X Turbo 依托更高规格的单机网络能力与系统优化,性能相较上一代方案提升 2 倍,提供更强的数据供给能力。
-
在追求更优 TCO 的场景下:在满足同等容量与性能需求的前提下,通过采用 15.36TB 高密度 NVMe SSD,F9000X Turbo 可将原方案所需的 16 台设备缩减至 8 台,节点数量减少 50%。
更高的单节点性能与容量密度,让客户能够以更少设备完成相同规模的数据承载,在减少硬件数量的同时,也进一步降低机柜空间、网络端口、能耗以及运维复杂度,为大规模 AI 基础设施带来更优的整体投入产出效率。
这也意味着,焱融全闪 AI 存储 F9000X Turbo 的升级不只是追求“更快”,还进一步提升单位节点、单位空间与单位成本所能交付的有效存力。
MLPerf 权威实测,刷新全球 AI 全闪性能纪录
F9000X Turbo 的性能提升,也在国际权威 AI 存储基准测试 MLPerf Storage 中得到了验证。
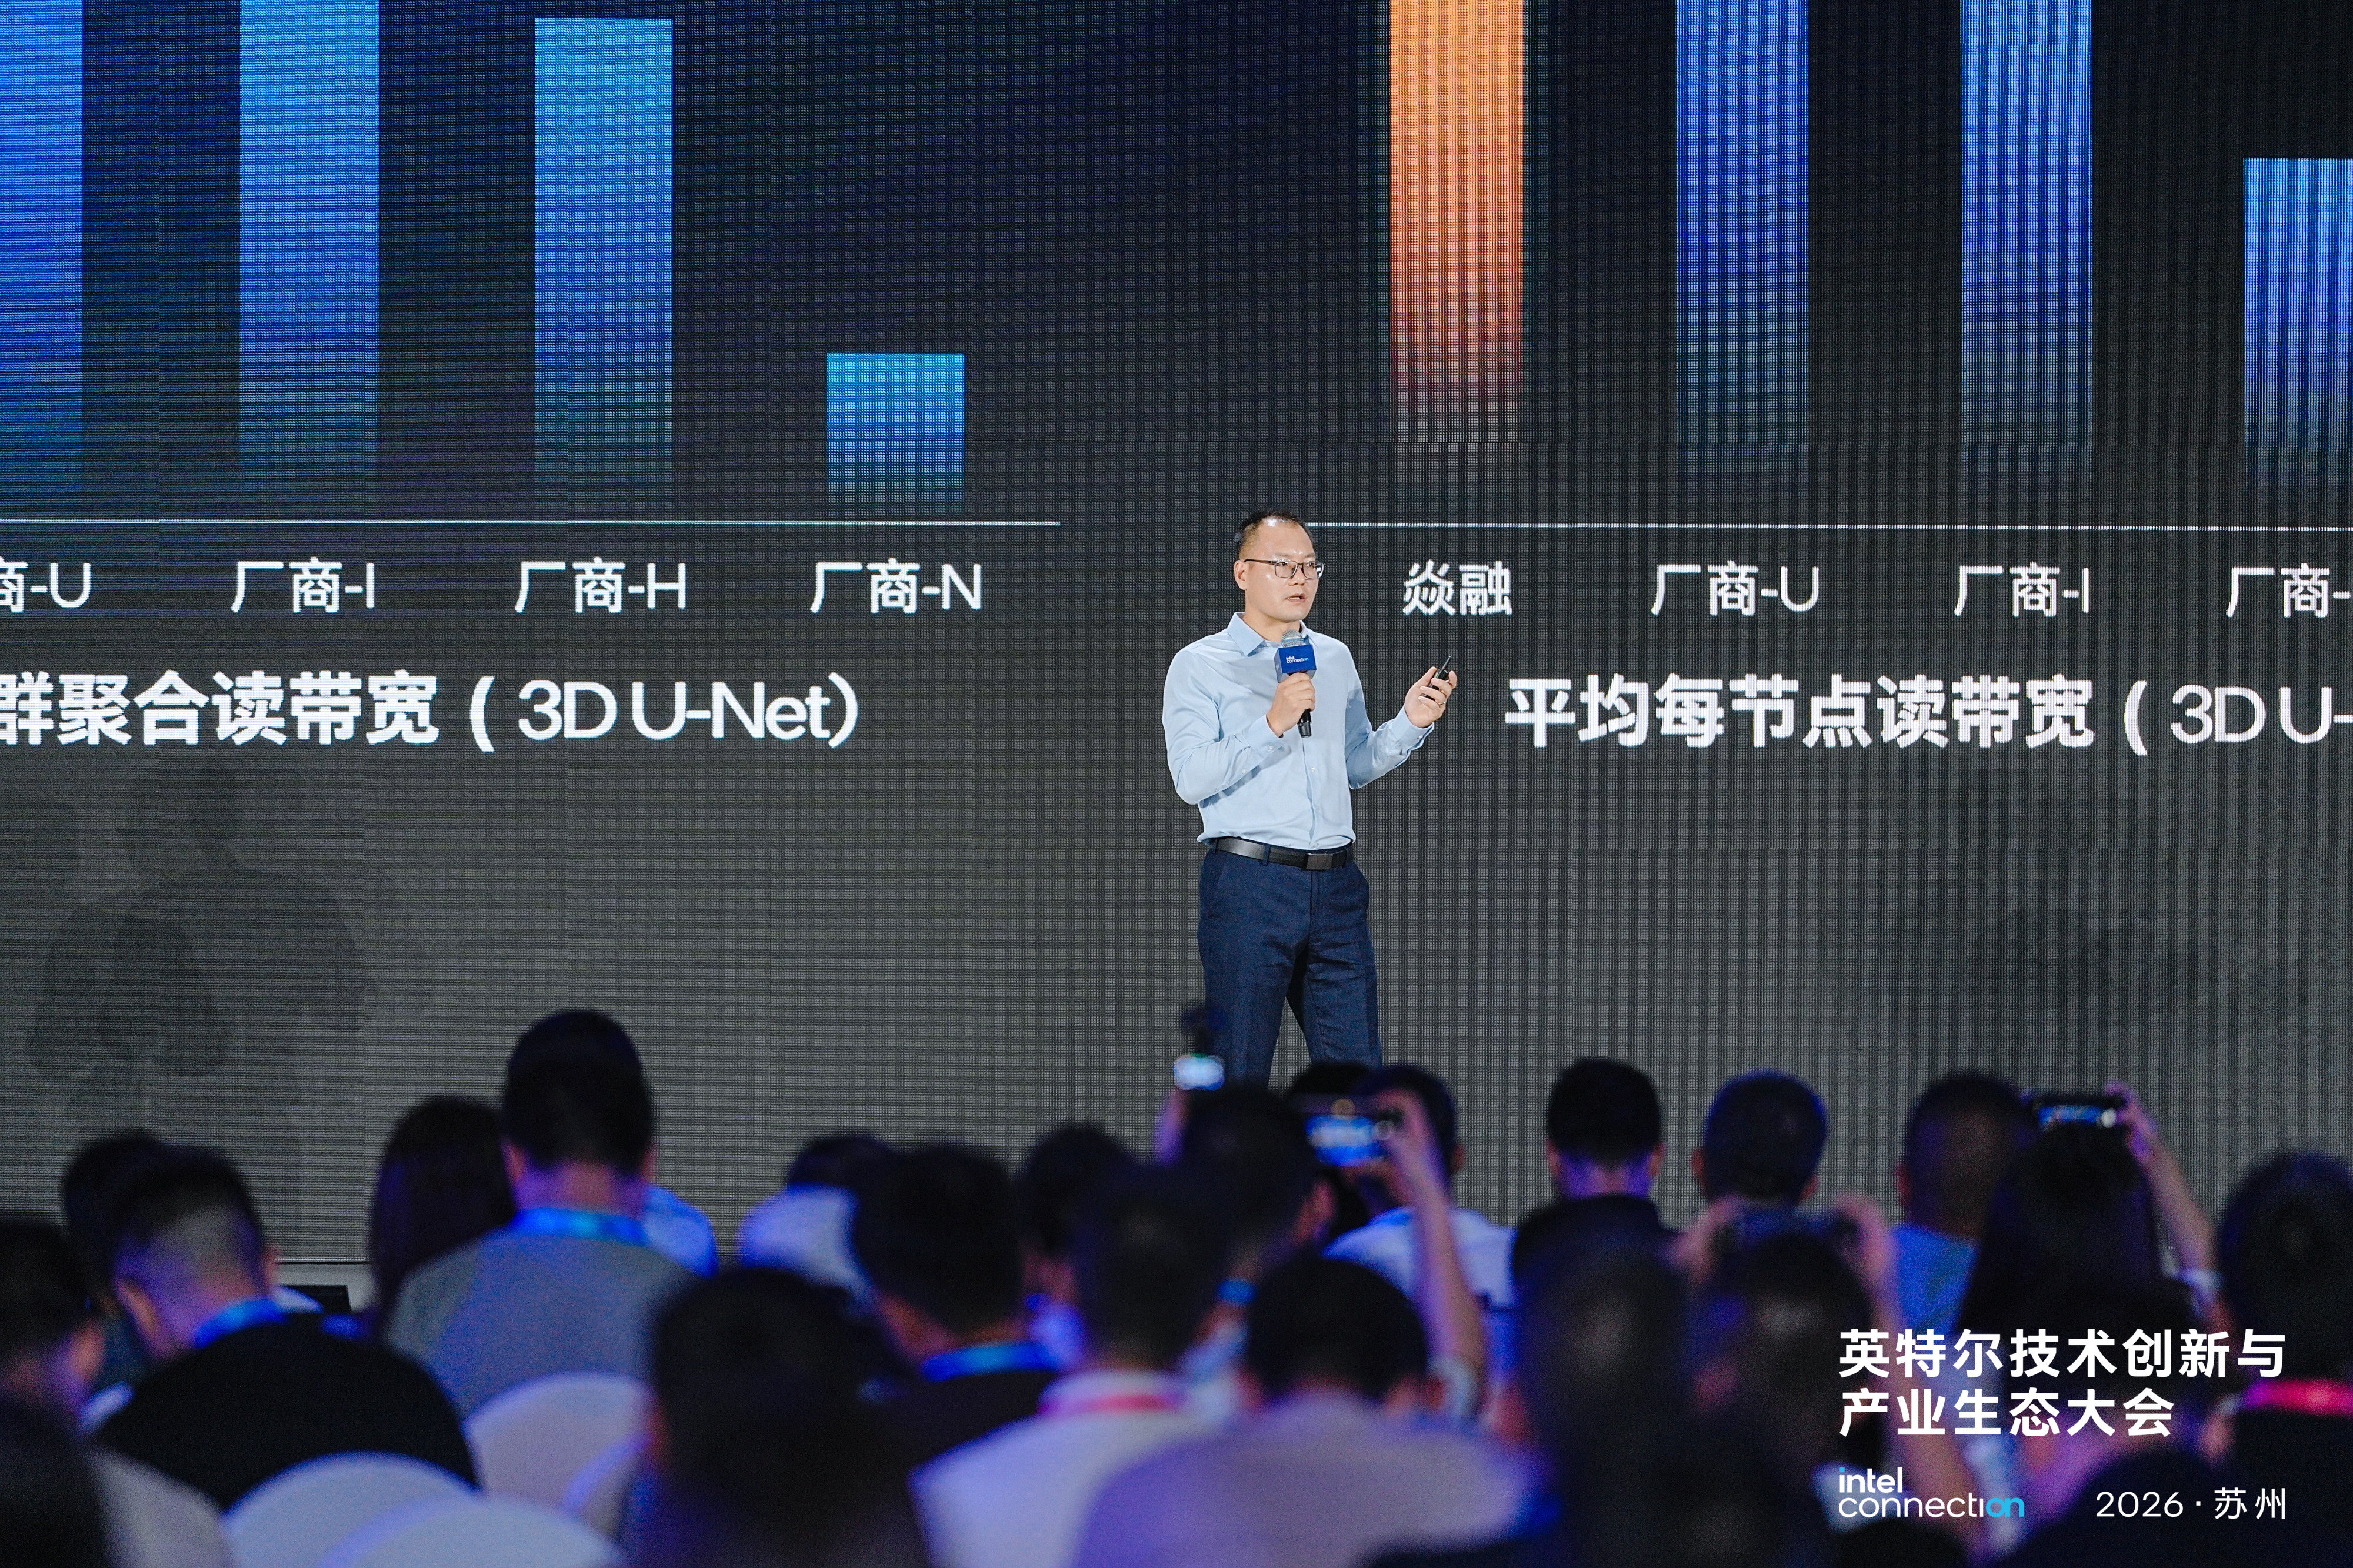
今日上午,在 Intel Connection 2026 主会场,英特尔数据中心事业部副总裁、中国区总经理陈葆立发表重要主题演讲,其中重点展示了 F9000X Turbo 在最新 MLPerf Storage v3.0 全球基准测试中的表现。F9000X Turbo 在 Llama 3-70B Checkpoint 与 3D U-Net 等核心 AI 工作负载场景中斩获多项第一,领跑全球 AI 存储赛道。

英特尔数据中心事业部副总裁、中国区总经理陈葆立,展示 F9000X Turbo 在全球 MLPerf Storage v3.0 基准测试取得的成绩
其中,焱融 F9000X Turbo 三节点集群在 3D U-Net 场景下实现 544 GiB/s 聚合读带宽,刷新世界纪录。这也是继 2024 年、2025 年之后,焱融全闪 AI 存储第三年刷新 MLPerf 全球榜首纪录,再次树立了 AI 原生全闪存储的性能新标杆。
从单节点性能打磨,到大规模集群效率优化,焱融持续通过自研软件、高速网络、存储介质与硬件平台的协同创新,不断突破 AI 存储能力上限。在同等 GPU 集群规模下,更高效的存储系统能够以更快速度完成数据读取与供给,缩短 GPU 等待时间,最大化昂贵算力资源利用率。
全闪进阶,存力全开
从更高吞吐、更高 IOPS,到更高容量密度与更优 TCO,F9000X Turbo 的发布,是焱融全闪 AI 存储产品的一次全面升级,也是焱融持续强化 AI 高性能数据底座能力的重要一步。
未来,焱融科技将持续携手英特尔等生态伙伴,围绕 AI 各类核心工作负载持续推进存储技术创新,以高性能、高效率、低成本的存力基础设施,持续释放 GPU 算力,加速大规模 AI 产业落地。