- Hardware Appliances
- 全闪存储一体机 F9000X
- Hybrid-Flash Storage
KV Cache 正在成为AI 推理新的基础设施
随着上下文窗口、并发规模及 Agent 应用持续增长,KV Cache 规模快速膨胀,对有限的 GPU 显存形成持续压力。当显存难以承载更多上下文时,不仅会影响推理响应速度,限制并发规模与上下文长度,也将进一步推高算力投入与推理成本。KV Cache 因此正从推理引擎内部的临时缓存,演变为需要在整个推理集群中统一管理、分层存储、智能调度与高效复用的关键上下文资源。
焱融 YRCache 推理存储系统通过构建覆盖 GPU 显存、主机内存、本地 SSD 及共享缓存的多层 KV Cache 架构,将原本受限于单机显存的缓存资源扩展为可分层存储、智能调度、共享复用的统一上下文空间,突破显存容量限制,减少重复计算与数据等待,持续释放 GPU Token 生产力。

更低时延
减少重复 Prefill,显著缩短 TTFT
减少重复 Prefill显著缩短 TTFT

更高吞吐
提升 KV Cache 命中与复用效率
提升 KV Cache 命中与复用效率

更长上下文
突破 GPU 显存及单机容量限制
突破 GPU 显存及单机容量限制

更优 TCO
以存代算,提升 GPU 资源利用率
以存代算提升 GPU 资源利用率
焱融 YRCache 多级 KV Cache 架构焱融 YRCache多级 KV Cache 架构
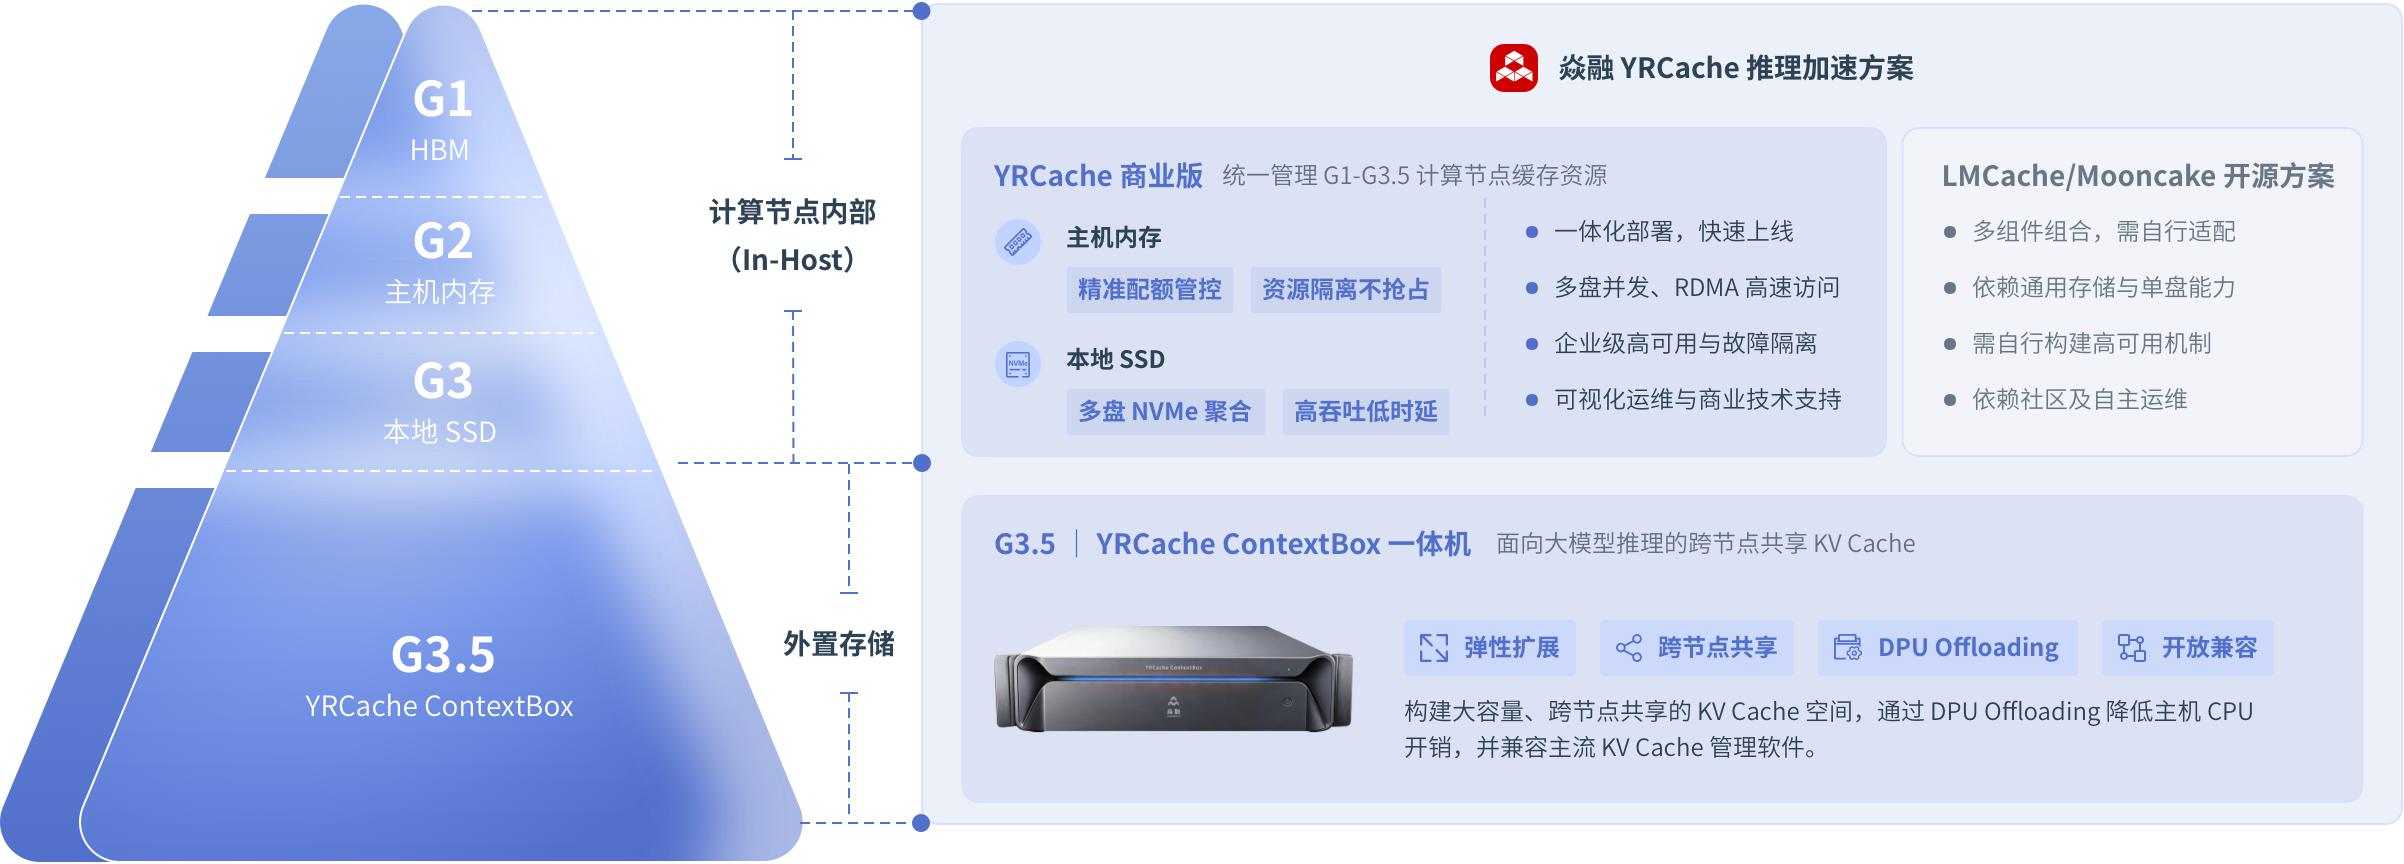
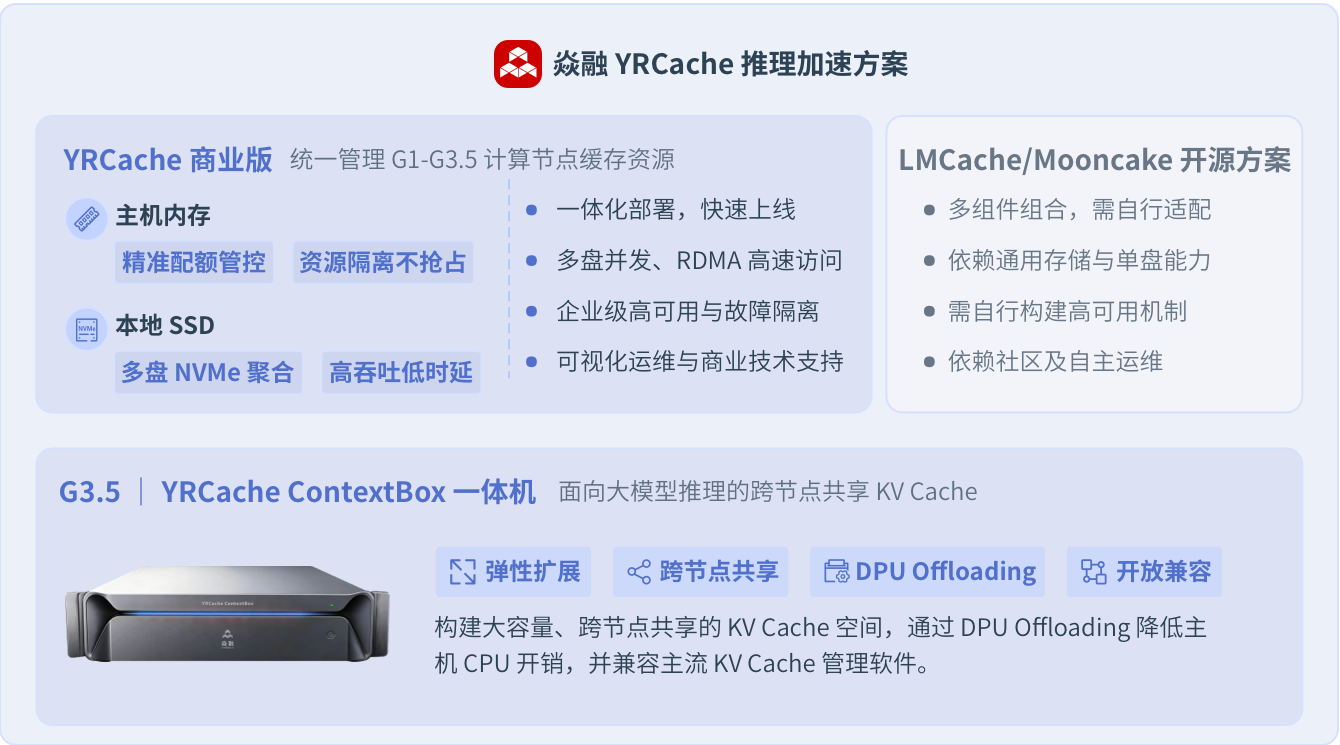
以存代算让每一块 GPU 生产更多Token
国内首个!焱融 YRCache 通过 ODCC KVCache 权威认证
国内首个!焱融 YRCache 通过 ODCC KVCache 权威认证
- 97%TTFT 降低
- 97%TPOT 降低
- 22xToken 吞吐量提升
面向 AI 推理重新设计KV Cache 数据路径
智能缓存调度
根据缓存热度、GPU 显存状态和推理任务需求,通过预加载、冷热分层、动态迁移等策略,让 KV Cache 在不同层级之间智能流动,在性能、容量与成本之间实现动态平衡。
跨节点 KV Cache 共享
打破单机缓存孤岛,让不同 GPU 节点之间共享和复用已经计算生成的 KV Cache,减少重复 Prefill 与数据搬运,提升集群整体缓存命中率和计算效率。
原生支持 PD 分离架构
深度适配 Prefill/Decode 分离场景,可将 Prefill 阶段生成的 Prompt Cache 高效保存并供后续请求直接复用,减少重复计算,加速 Decode 阶段 Token 生成。
灵活的多层级配置
不同业务并不需要强制部署全部缓存层级。YRCache 可根据 GPU 类型、集群规模、上下文长度和性能目标灵活组合 HBM、DRAM、本地 NVMe、ContextBox 一体机,实现性能与成本的最佳匹配。
无缝融入主流 AI 技术栈
通过标准 API、YRConnector 等方式连接推理引擎,适配 vLLM、SGLang 等主流推理框架,并支持 NVIDIA 与国产 GPU 平台,降低现有 AI 集群的改造与部署复杂度。