- Hardware Appliances
- 全闪存储一体机 F9000X
- Hybrid-Flash Storage
AI 推理专属 G3.5 共享缓存层
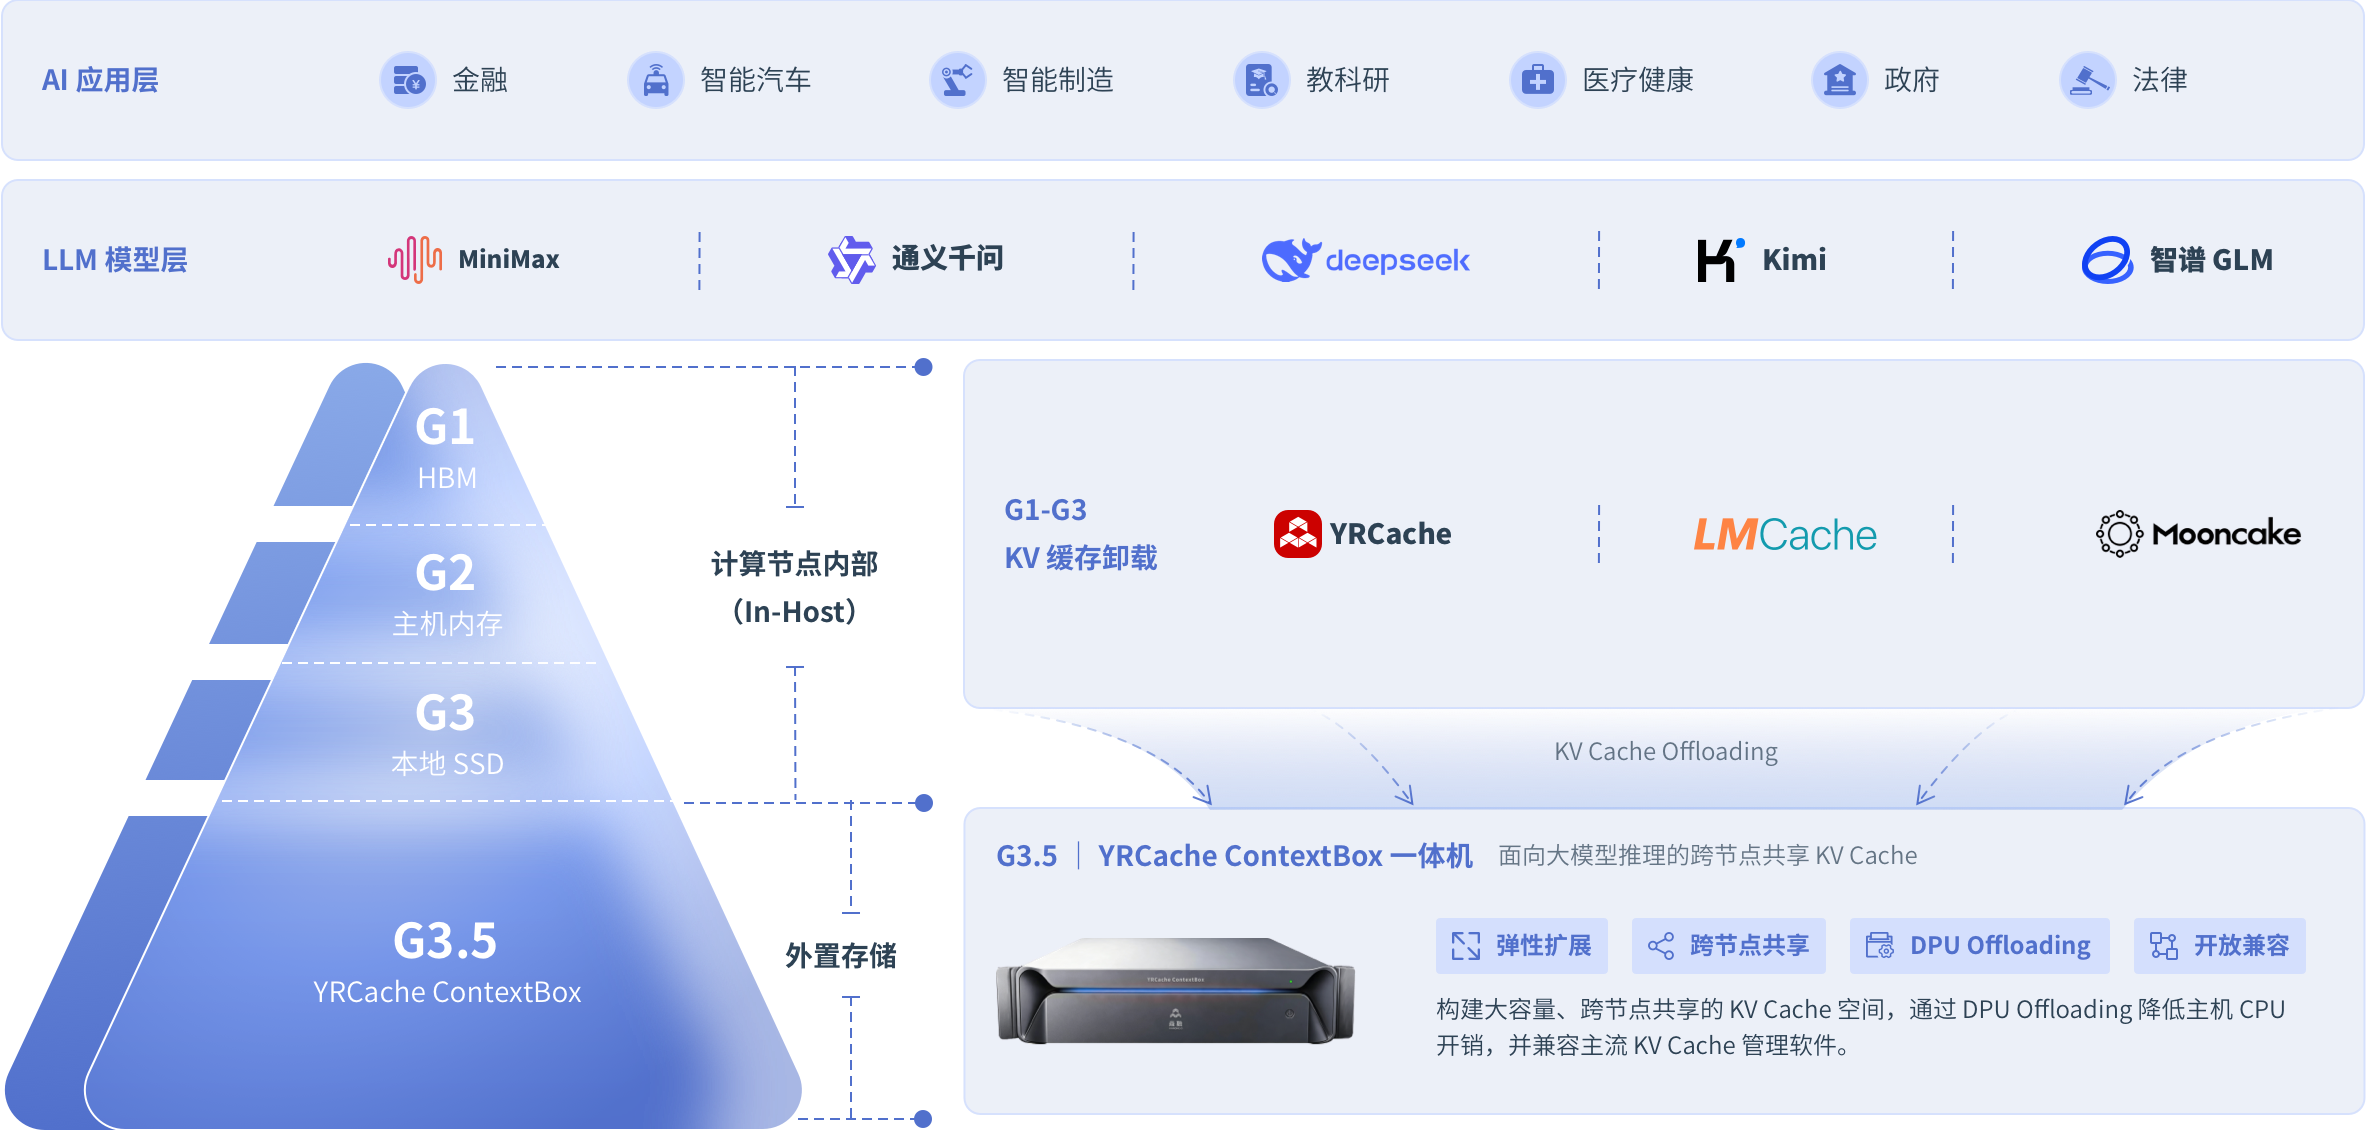
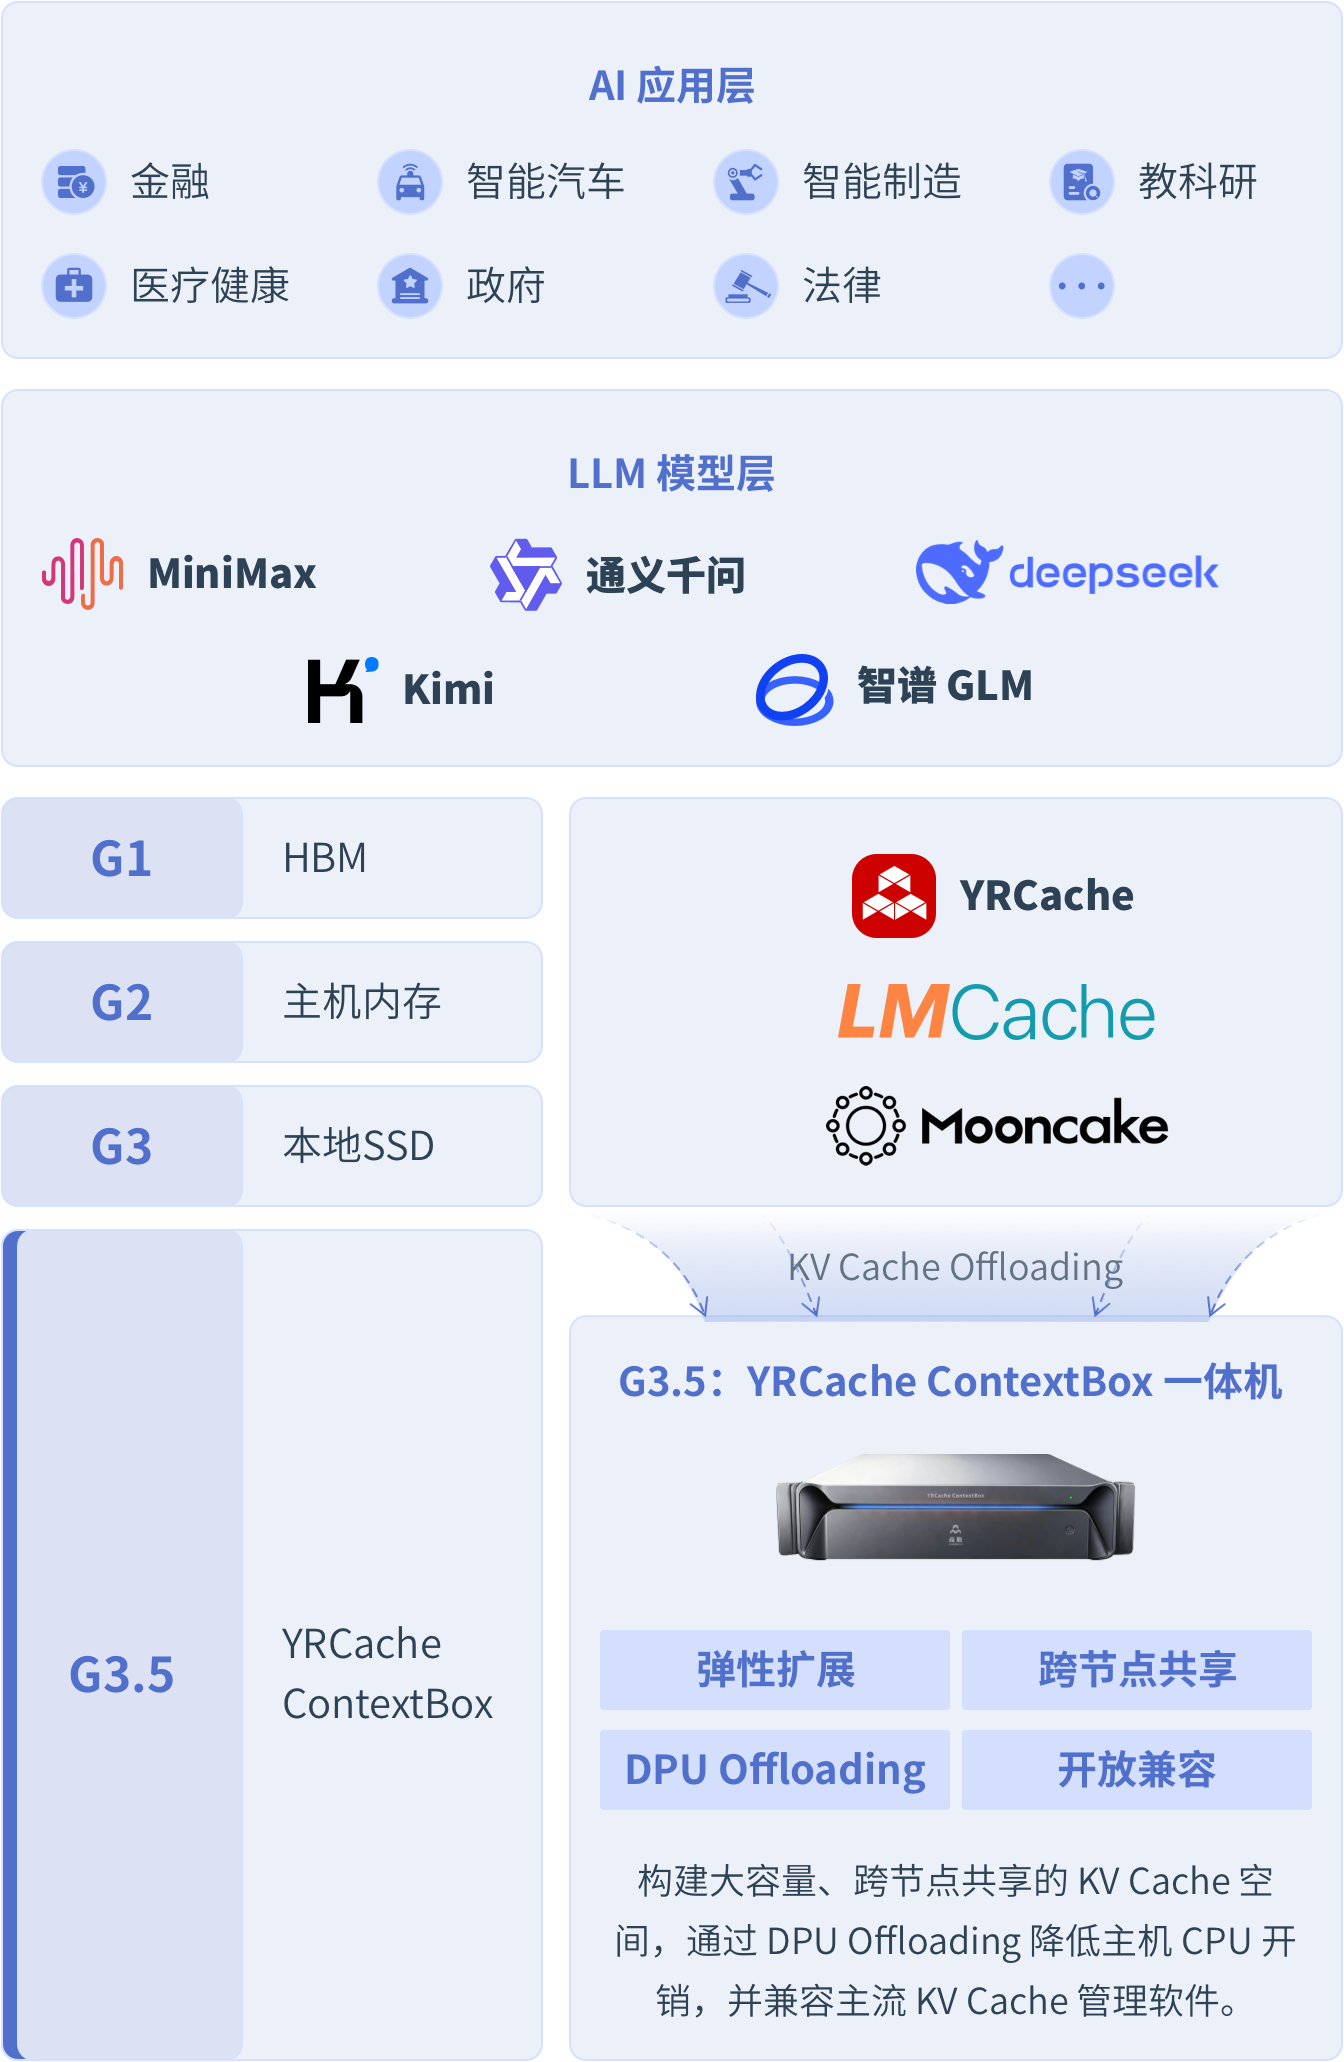
焱融 YRCache ContextBox 一体机针对 KV Cache 访问特征设计,通过构建独立于计算节点之外的高性能共享缓存池,为不同 GPU/NPU 节点提供统一的上下文访问空间,实现 KV Cache 的跨节点共享、快速复用与弹性扩展。它补齐了本地 SSD 与持久化共享存储之间的能力断层,突破单机容量边界,减少重复 Prefill 与数据搬运,为长上下文、Agent、PD 分离及高并发推理提供高性能、可扩展的共享上下文基础设施。
三大核心能力重塑 KV Cache 存储架构
打破缓存孤岛
将分散在不同节点的 KV Cache 汇聚为共享上下文空间,支持跨节点访问与复用,减少重复 Prefill,提升缓存复用效率。
突破单机容量
通过独立扩展的共享缓存层,突破单机 DRAM 与 SSD 的容量限制,为长上下文、高并发推理提供更大的缓存空间。
实现存算解耦
缓存资源不再绑定单一 GPU 服务器,可按业务需求独立扩展与统一调度,提升集群弹性和资源利用率,降低 GPU 扩容压力。
YRCache ContextBox 共享缓存架构图产品架构
YRCache ContextBox 基于系统级 Co-design 理念,将 DPU、高性能存储介质、高速网络与 YRCache 软件深度融合,构建端到端优化的 KV Cache 数据访问路径。
核心优势
集群级协同
让上下文真正成为共享资源
提供跨节点共享的原生上下文空间,让多个推理节点直接复用已有 KV Cache,减少数据冗余和重复计算。
极速响应
让更多 GPU 时间用于 Token 生成
通过高速访问和 KV Cache 复用,减少重复 Prefill 与 I/O 等待,加速首 Token 响应和 Token 输出。
突破显存限制
支撑更长上下文、更高并发
将大规模 KV Cache 从有限的 GPU 显存和单机 SSD 扩展至共享缓存池,无需依赖持续增加 GPU 获取更多显存。
弹性扩展
让计算与缓存独立扩缩
计算节点与缓存容量可根据业务需求分别扩展,让推理集群能够更加灵活地应对业务峰谷。
开放生态
快速融入现有 AI 集群
采用软硬件解耦架构,兼容 NVIDIA 与国产 GPU,及 vLLM、SGLang 等主流推理框架,降低 AI 集群接入门槛。
应用场景
长上下文推理
面向长文档分析、代码、复杂推理等超长上下文任务,通过大容量共享缓存降低重复上下文计算开销
多轮对话
历史上下文可持续保存并跨节点复用,在请求迁移后依然保持较高的缓存命中效率
PD 分离推理
让 Prefill 产生的 KV Cache 能够被 Decode 节点快速访问,减少节点之间的数据孤岛
Agent / Multi-Agent
为复杂 Agent 工作流提供共享上下文空间,支持不同计算节点和 Agent 之间更加高效的上下文访问与状态复用
Token 工厂
面向大规模高并发推理集群,通过 KV Cache 共享与复用减少无效 GPU 计算,提高单位算力 Token 生产效率