过去几年,大模型产业的发展几乎围绕同一个主题展开:更大的模型、更多的 GPU、更长的上下文。
随着 Agentic AI、长上下文推理以及 Token Factory(Token 工厂)模式兴起,行业开始发现一个新的现实——影响推理系统效率和成本的关键因素,已经不再只是算力,而是如何管理规模持续膨胀的 KV Cache。这一趋势在 GTC 2026 上得到进一步验证。NVIDIA 发布 CMX(Context Memory Extension)架构,并首次提出 Context Memory Storage 体系,将 KV Cache 从单一 HBM 显存扩展至 HBM、DRAM 和 NVMe SSD 组成的多级缓存架构。SSD 不再只是传统存储设备,而被正式纳入 AI 推理的数据通路,成为承载海量上下文数据的重要组成部分。
这背后反映的是 AI 推理架构的一次根本性变化。
从显存到缓存竞争
SSD正在成为AI推理新基础设施
随着长上下文和多 Agent 应用快速普及,KV Cache 规模正在从 GB 级暴涨至 TB 级。继续依赖昂贵且稀缺的 HBM 扩容,已经难以满足推理服务规模化发展的需求。相比之下,SSD 具备容量大、成本低、扩展灵活等天然优势,成为承接温数据和历史 KV Cache 的最佳选择。
因此,行业正在逐步形成共识:HBM 负责实时热点数据,DRAM 负责活跃上下文,而 SSD 负责大规模 KV Cache 扩展存储。“HBM + DRAM + SSD”三级缓存体系,正成为下一代 AI 推理基础设施的重要演进方向。
事实上,早在 NVIDIA 发布 CMX 之前,焱融科技便已围绕这一方向展开布局。2025 年发布的 YRCache 推理存储系统,核心设计理念便是通过多级缓存架构管理 KV Cache,实现 GPU 显存、内存与 SSD 资源协同调度,提升推理系统整体资源利用率与 Token 生产效率。如今,随着 NVIDIA 将多级 KV Cache 架构推向产业标准,AI 基础设施竞争也正在从单纯的算力竞争,转向缓存体系与数据流效率的竞争。而这恰恰验证了焱融在 AI 推理存储方向上的领先技术判断。
为什么存力正在决定Token收益?YRCache 给出答案
在大模型推理架构演进的关键拐点,行业竞争正从单纯的“算力堆叠”转向“存力 + 调度”的博弈。面对长上下文显存不足、高并发延迟偏高、GPU 算力闲置以及运营成本高昂等行业痛点,焱融科技并未停留在概念层面,而是从战略、产品、实测、生态四个层面务实推进,紧密贴合 DeepSeek 等新一代大模型的推理架构需求。2026 年,公司顺利完成近亿元 C 轮融资,持续加码 AI 推理存力基础设施。
1. 战略聚焦:锚定 KV Cache 分层存储,规避同质化
自 2025 年起,焱融科技持续推进产品与技术方向的演进,将 AI 推理温数据基础设施作为重点投入领域,围绕 KV Cache 全生命周期管理与分层存储架构持续优化。
KV Cache 全生命周期管理;
-
HBM-DRAM-SSD 三级缓存智能调度;
-
大规模推理集群的存算协同优化
这一战略调整直击行业痛点,旨在彻底解决大模型推理场景中的显存焦虑与算力浪费,夯实 AI 推理的存力基础。
2. 产品落地:自研 YRCache,原生适配三级缓存架构
作为国内较早原生支持 HBM-DRAM-SSD 全层级缓存管理的产品,自研 YRCache 推理存储系统自 2025 年发布以来已完成多轮迭代,深度适配 DeepSeek-R1、Llama 系列等主流大模型,其核心能力表现为:
-
智能预取与热点预测:自动识别高频访问的 KV 数据,大幅提升 SSD 命中率。
-
动态冷热调度:热数据自动留存在高速显存/内存,温数据下沉至性价比更高的 SSD。
-
大规模并发调度:支持数千级 GPU 共享 KV 缓存池,实现整体吞吐量的质跃。
-
GPU 直连 IO (GPUDirect Storage):绕过 CPU 转发开销,显著降低端到端延迟。
3. 商业模式升级:从算力硬件租赁转向 Token 量化运营
随着三级缓存架构逐步成为行业标配,AI 推理行业的商业化模式正在发生转变,行业逐步由原先按 GPU 硬件租赁计费,转向依托 Token 产出量核算收益的 Token 工厂运营模式,系统的 Token 吞吐能力直接决定服务商盈利水平。
沿用传统推理架构时,KV Cache 全部占用高成本显存与内存资源,高并发业务很容易耗尽显存空间。缓存资源饱和后,后续推理任务排队阻塞,GPU 算力空转闲置,即便持续采购增加算力硬件,整体 Token 产出效率也难以有效提升,成为制约 Token 工厂落地盈利的关键短板。
依托 YRCache 分层存储方案,大量 KV Cache 可下沉存储至 SSD,有效释放宝贵显存资源,推理集群能够承载更多会话与超长上下文请求。对算力运营企业而言,在现有硬件投入不变的前提下,Token 产出能力得到明显提升,单位 Token 硬件成本随之下降,为 Token 商业化落地创造良好的经济效益。
4. 权威实测:YRCache让中端GPU也能获得接近高端卡的推理产能
2026 年 3 月,ODCC 联合 NVIDIA 开展 KV Cache 专项评测,基于 DeepSeek-R1 大模型,在 400Gb、800Gb 两种网络环境下,对比中端 RTX 6000D 与高端 H20 显卡,分别测试原生 vLLM、集成 YRCache 两套方案的实际表现。
在原生部署条件下,受限于显存容量约束,RTX 6000D 推理延迟偏高、整体吞吐量仅为 H20 的 30%,硬件性价比不足。接入 YRCache 分层存储方案后,大量 KV Cache 数据下沉至 SSD,两款显卡的性能差距快速收窄:400Gb 与 800Gb 网络中,RTX 6000D 综合性能分别达到 H20 的 76%、79%,首包延迟、单 Token 生成耗时两项关键指标基本看齐高端卡。
从投入收益测算来看,以原生 H20 方案作为基准,RTX6000D+YRCache组合在 400Gb、800Gb 环境下 ROI 分别提升 11.01 倍、14.17 倍。同等资金投入,中端硬件搭配 YRCache 可以实现远超高配原生方案的 Token 产出。
实测结果落地验证了分层缓存路线的商业价值:企业不必大规模采购昂贵 HBM显卡,依靠性价比中端 GPU+YRCache 即可逼近高端算力表现,以硬件平权有效控制 Token 工厂的算力投入成本。


5. 生态合作:全栈国产适配与规模化场景落地
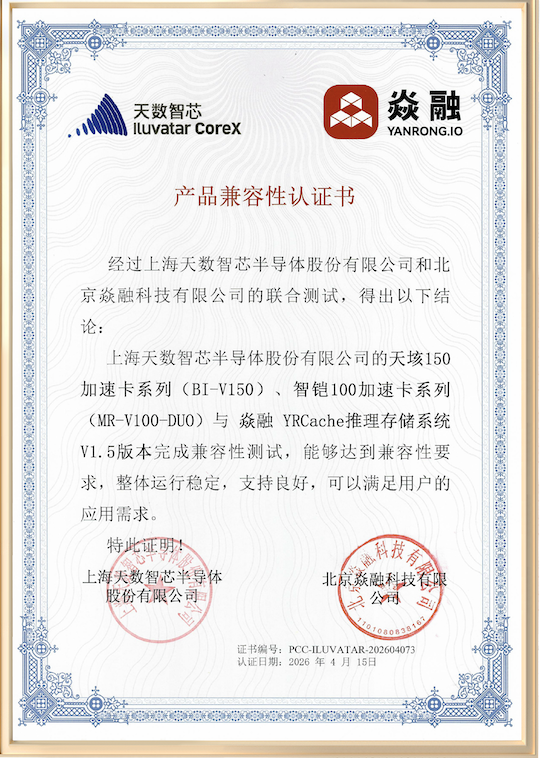
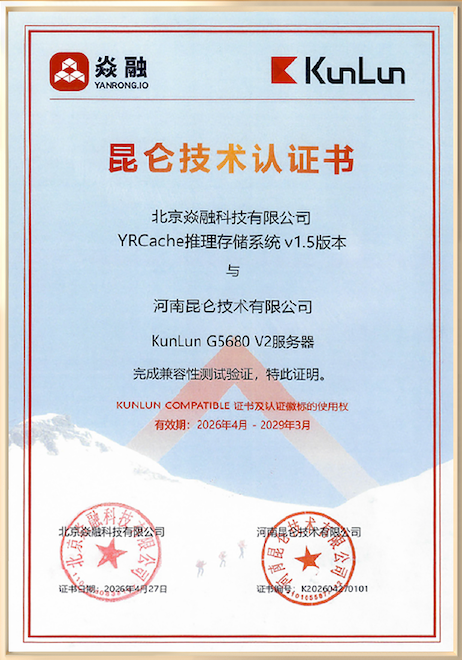
焱融科技持续推进全栈算力生态适配,聚焦国产算力体系优化与行业标准共建,具备成熟的大规模商业化交付能力:
-
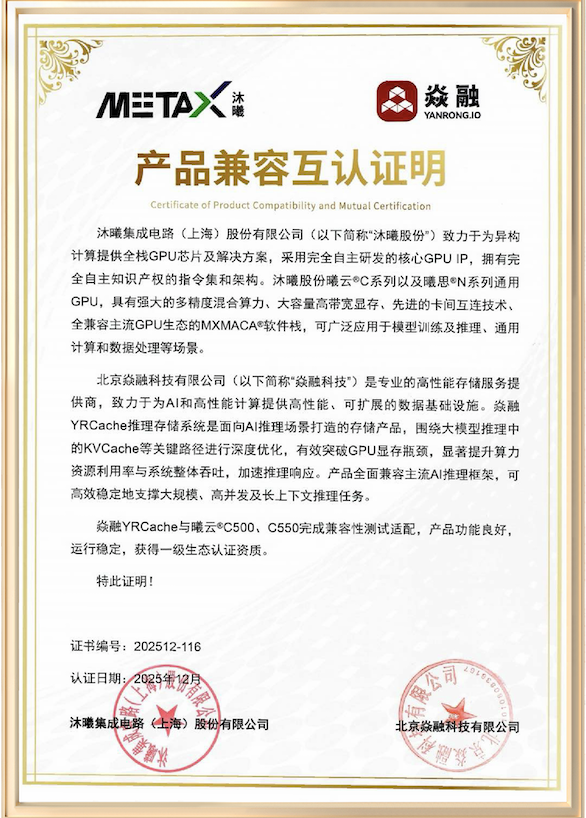
国产算力适配:2026 年 4 月,YRCache 与沐曦曦云 C500/C550 GPU 完成兼容性认证,正式支持国产 GPU + SSD 的 KV Cache 方案落地。
-
行业标准共建:深度参与中国信通院“AI 推理场景高性能存储技术推进计划”,积极共建 KV Cache 存储行业技术标准。
规模化落地:已在智算中心、互联网医疗、多轮对话 RAG、OpenClaw 智能体部署等主流 AI 场景完成规模化部署。单集群可支撑数千 GPU算力规模、PB 级 KV 缓存存储需求。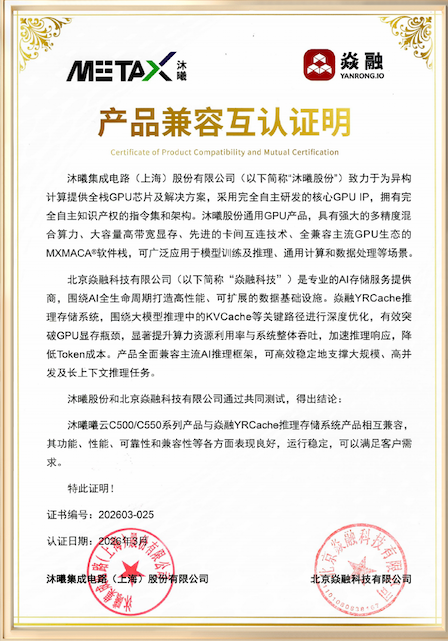

结语
AI 产业已告别单纯依靠堆砌 GPU 硬件的粗放发展阶段,进入依靠存力调度、数据流转效率提升收益的精细化发展阶段。伴随长上下文、Agent 应用持续落地,KV Cache 精细化管理能力,成为智算基础设施建设的关键一环。
焱融科技提前预判三级缓存产业趋势,完成 YRCache 产品研发、第三方实测验证、多行业规模化落地,持续深耕 AI 推理存储底座。后续公司将持续迭代 KV Cache 相关技术,紧跟 Token 工厂发展趋势,通过存储技术优化帮助大模型产业降本增效。
关于焱融科技
焱融科技是中国领先的全栈 AI 存储解决方案提供商,围绕 AI 全生命周期打造高性能、可扩展的数据基础设施。面对 AI 推理场景的核心挑战,焱融科技推出 YRCache 推理存储系统,针对 KVCache 等关键路径进行深度优化,通过多级缓存架构突破 GPU 显存瓶颈,显著降低首 Token 延迟、提升 Token 吞吐能力,并有效摊薄单位 Token 推理成本。焱融科技以极致存储性能覆盖 AI 训练、推理、数据治理全链路,确保每一块 GPU 在最优数据供给下释放全部效能,为企业构建稳定、高效、低成本的 AI 基础设施底座。